平时做技术实践时,很多问题不是概念不会,而是细节没串起来。拿“采用Python计算输入文件摘要的示例”来说,它看着像小点,放到项目里常会牵出环境、配置、兼容性和维护成本。下面按实际采用顺序,把思路、关键写法和容易踩坑的地方讲清楚,便于大家直接对照操作。
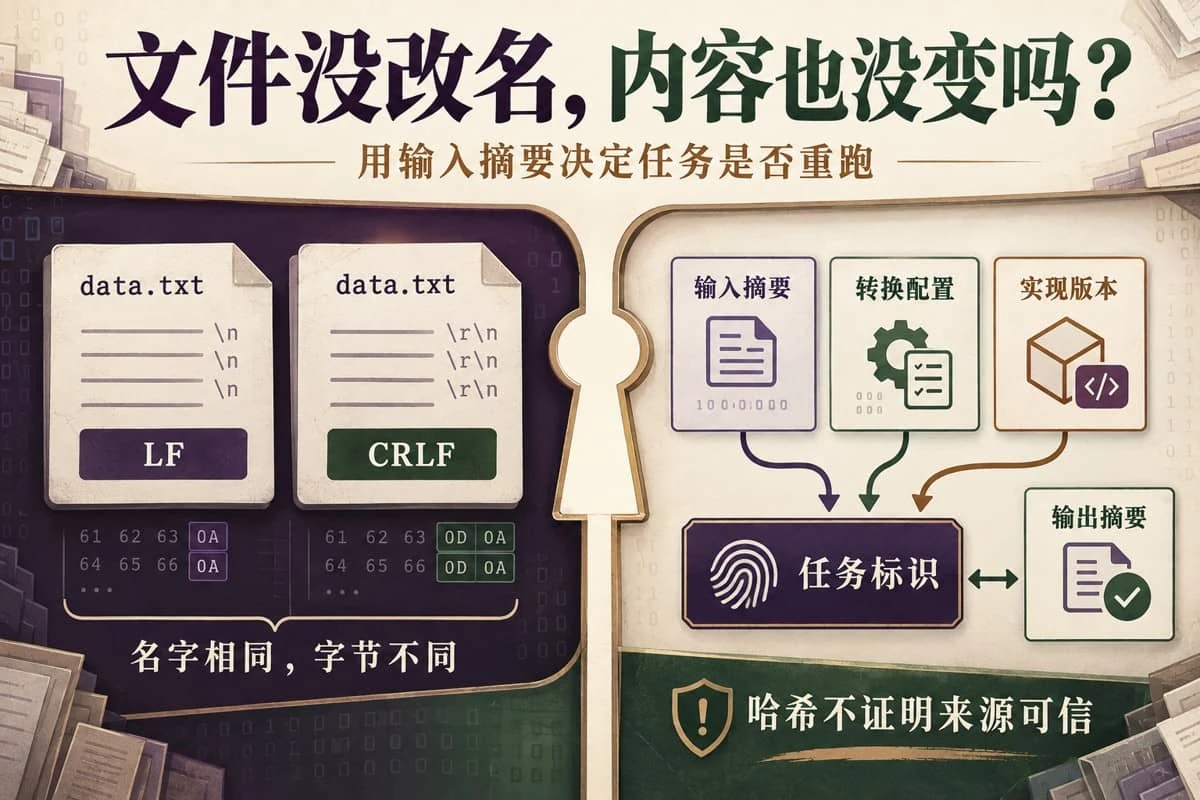
从实现思路看,批处理程序第二次启动,发现输出文件存在,就跳过这项任务。若输入同名文件已经被替换,输出仍在,这个判断会把旧结果当成新结果。
理解这一步时,文件名适合定位路径,不能代表内容版本。这里用 SHA-256 记录实际读取的字节,再把输入摘要、转换设置与实现版本组合成任务标识。讨论的是普通文件转换任务,不依赖任何模型。
先决定对原始字节还是规范化文本求摘要
从实现思路看,假设文件里只有“退款”两个字和一个换行。UTF-8 编码下,LF 版本为 7 字节,CRLF 版本为 8 字节。肉眼看到的行可能一样,原始字节摘要却不同。
结合项目来看,若转换任务要求保留原始文件,就对原始字节求摘要;若任务允许统一换行,可另外保存规范化内容摘要,同时记录规范化规则。不能先以文本模式读入、默认转换了换行,再称它为“原文件摘要”。
理解这一步时,下面函数以二进制模式分块读取,同时累计实际读取字节数。65536 是本例块大小,不是经过基准测试选出的最优值。
import hashlib
from pathlib import Path

def fingerprint(path):
    digest = hashlib.sha256()
    size = 0
    with Path(path).open("rb") as f:
        for block in iter(lambda: f.read(65536), b""):
            size += len(block)
            digest.update(block)
    return {"sha256": digest.hexdigest(), "bytes": size}
hashlib.update 分次输入字节,相当于对它们的串接求摘要。代码避免一次把整个文件读进内存,但仍然完整读取每个字节。读到一半发生权限或 I/O 异常时,函数会抛错,不得到部分摘要;调用方不能捕获后把它登记为已完成。
输入相同,转换设置也可能已经不同
在这个场景下,同一文件按“保留空白”和“去除首尾空白”处理,输出可能不同。只把输入摘要作为缓存键,会把两种任务混为一谈。任务标识应包含真正影响输出的设置及实现版本。
import json

def task_key(source, config):
    payload = {
        "input": source["sha256"],
        "config": config,
        "implementation": "demo-v1",
    }
    raw = json.dumps(
        payload, sort_keys=True, separators=(",", ":"),
        ensure_ascii=False, allow_nan=False,
    ).encode("utf-8")
    return hashlib.sha256(raw).hexdigest()
实际处理时,这个函数与前一个放在同一脚本即可采用。设置限定为字符串键和 JSON 兼容的值,不允许 NaN、无穷大或自定义对象。排序键、固定分隔符和 UTF-8 编码,是本例固定的序列化约定;它不是通用的跨语言规范化协议。跨语言共享标识时还要统一数字和 Unicode 等表示。
demo-v1 只适用来这段演示。正式任务应记录可追溯的实现版本或内容摘要;如果忘记随行为变化更新版本,这个标识同样会失效。会影响输出的外部字典、时区或依赖版本也要纳入约定,不能只看设置文件。
一个能够直接复核的小例子
从实现思路看,把下面几行接在同一脚本末尾,在一个自行选择的测试目录运行。这里采用临时目录,避免覆盖已有文件。
from tempfile import TemporaryDirectory

with TemporaryDirectory() as folder:
    path = Path(folder) / "input.txt"
    path.write_bytes("退款n".encode("utf-8"))
    a = fingerprint(path)
    first = task_key(a, {"strip": False})
    path.write_bytes("退款rn".encode("utf-8"))
    b = fingerprint(path)
    print(a["bytes"], b["bytes"], a["sha256"] == b["sha256"])
    print(first == task_key(a, {"strip": False}))
    print(first == task_key(a, {"strip": True}))
在这个场景下,同样两组字节和设置在本地 Python 3.9.6 下核验,结果为 7 8 False、True、False。它们说明换行字节改变会改变输入摘要,相同设置能重建相同任务标识,改变设置会改变标识。没有测量读写吞吐、百万文件开销或异常恢复成功率。
输出存在,还要核对它对应哪项任务
在这个场景下,任务完成后,登记输入定位信息、输入摘要、任务标识、输出位置和输出摘要。下一次启动,先重新计算本次任务标识,再查登记记录;只有记录匹配、输出存在且摘要一致时,才允许跳过。
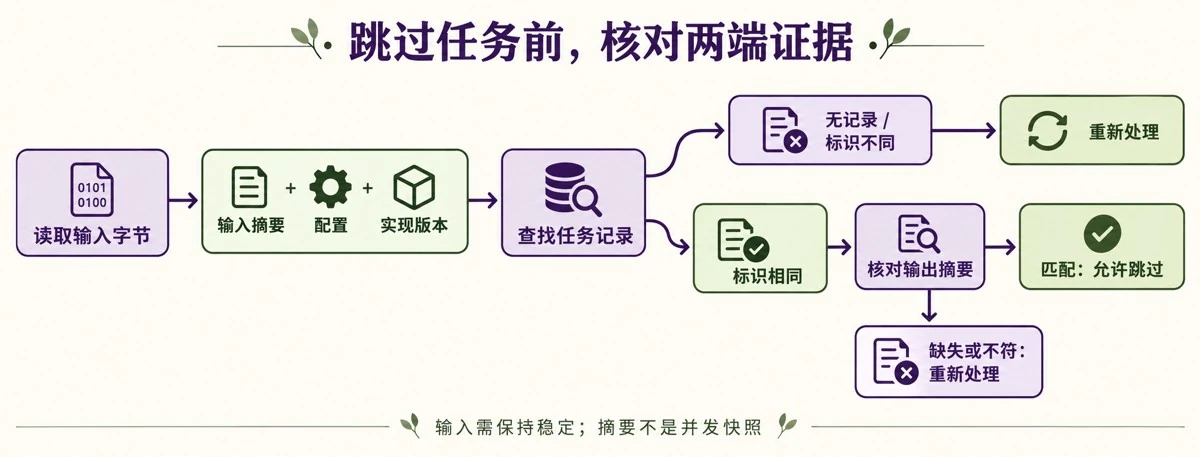
实际处理时,若输出被人工修改,旧记录虽然还在,摘要检查也应阻止跳过。若任务输出是多个文件,需逐项清单,不能只对目录名字求摘要。登记与输出之间的提交一致性还需单独设计:输出写成功但记录未提交,或者记录已写入而输出不完整,都不能靠一个哈希函数自动解决。
摘要不是输入快照,也不是来源证明
实际处理时,文件在读取时被其他进程修改,分块读取可能得到不同时间片的内容。前后比较大小与修改时间只能发现部分变化,不能给出严格快照保证。需稳定输入时,应从不可变版本读取,或采用适合该文件系统的快照、发布与协作机制。上面的演示默认输入在读取期间保持不变。
从实现思路看,SHA-256 能够用来内容一致性核对,却不能证明是谁写的文件。若文件和登记记录一起被修改,比较仍可能一致。可信来源、权限和记录保护是另外的问题。
落到代码里,这样保存摘要后,重跑判定就有了可核对的理由:这次输入、设置、实现和输出是否仍对应同一项计算。路径只是其中的定位信息。
理解这一步时,总的来说,Python计算文件摘要适合结合实际项目边做边理解。先抓住核心思路,再逐步补上细节和边界处理,最后效果会更稳定,也更容易复用。