AI怎么整理网页资料?用 Obsidian 剪藏生成笔记
需要给网页留下摘要、标签和原地址时,可以用 Obsidian Web Clipper。扩展先读取当前网页,再由 Interpreter 按模板提取信息,生成可保存到 Obsidian 的笔记。
第一步 打开剪藏面板,确认采集字段
在目标网页打开浏览器工具栏中的 Web Clipper。先看预览里的标题和 source,再确认正文模板有摘要和事实表的位置。图中展示的是公开人物资料页。
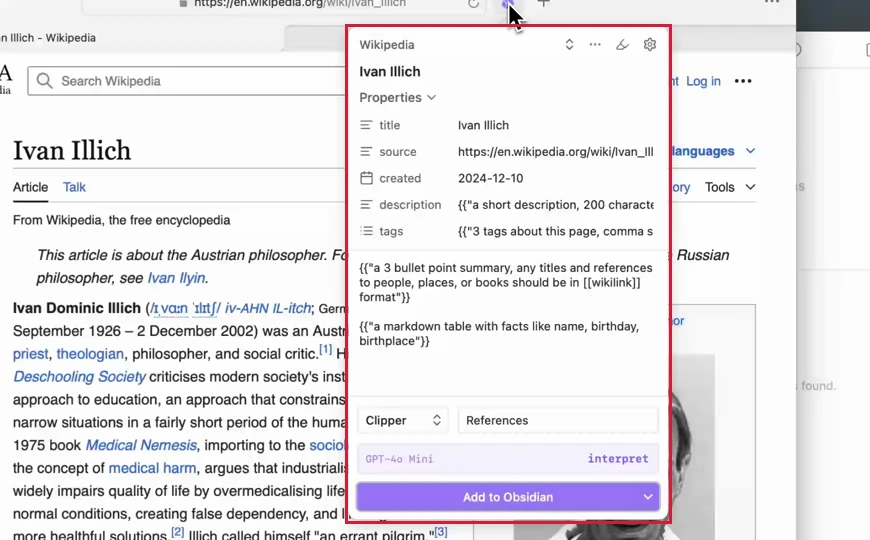
图 1 Obsidian Web Clipper 的网页剪藏面板
Web Clipper 是免费的开源浏览器扩展,可用于 Chrome、Edge、Firefox 和 Safari 等浏览器。扩展的发行版本可在安装页面核对,示例界面来自功能演示。剪藏结果保存到 Obsidian 库,模型服务的费用和额度由所选提供方决定。
第二步 用 Interpreter 提取要点
要显示 interpret 按钮,需要在扩展设置的 Interpreter 中启用该功能、配置模型,并在模板里加入提示词变量。可以在模板正文填入 {{"用中文提取三个要点。每个要点附可在网页找到的原文短句。缺少日期就写未注明。"}}。保留独立的 source 字段,方便回到原网页。打开剪藏面板后,检查模型选择,再点 interpret。
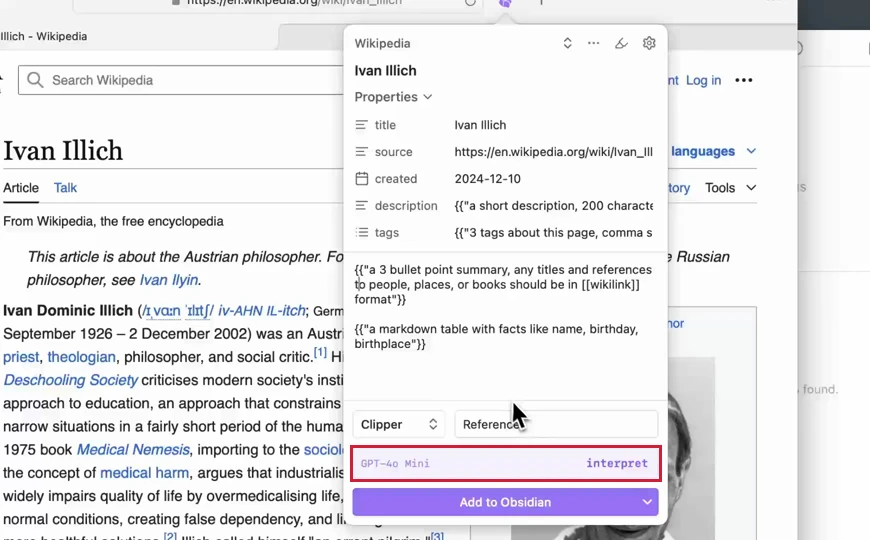
图 2 红框标出模型选择和 interpret 按钮
运行时会把模板所需的网页内容发给所选模型。默认上下文可能包含整个页面 HTML,可按模板限制到正文。遇到内部或登录后才可见的页面,先确认该内容获准交给所选服务处理。
第三步 核对预览并保存
处理结束后先看预览中的摘要和标签,再点 Add to Obsidian。以图中的人物资料为例,摘要里出现的著作、出生地等信息,需要回原网页核对。网页只给出了年份时,笔记也只保留年份。
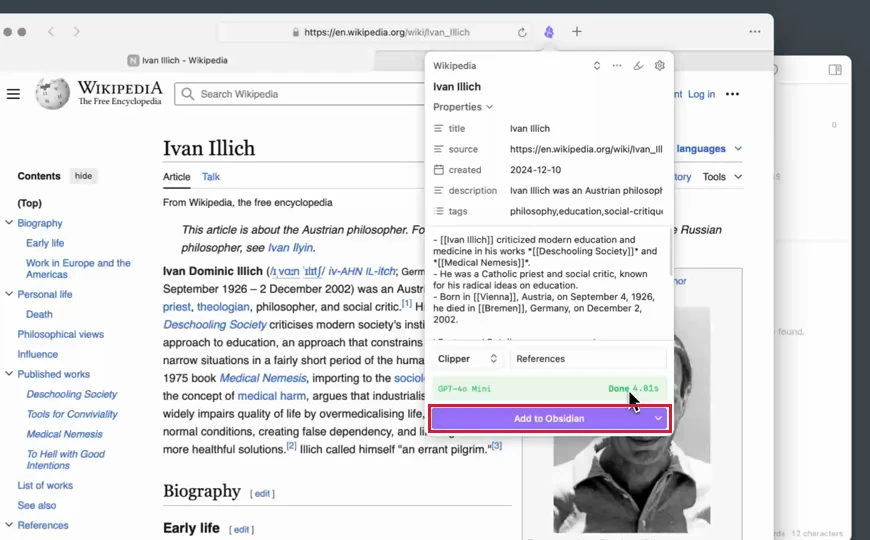
图 3 剪藏预览已生成,红框标出 Add to Obsidian
第四步 打开笔记,检查可追溯性
打开 Obsidian 里新增的条目,先找网页原址,再比对摘要和表格。两篇资料对同一项有不同说法时,可各保留一条记录及对应网页。
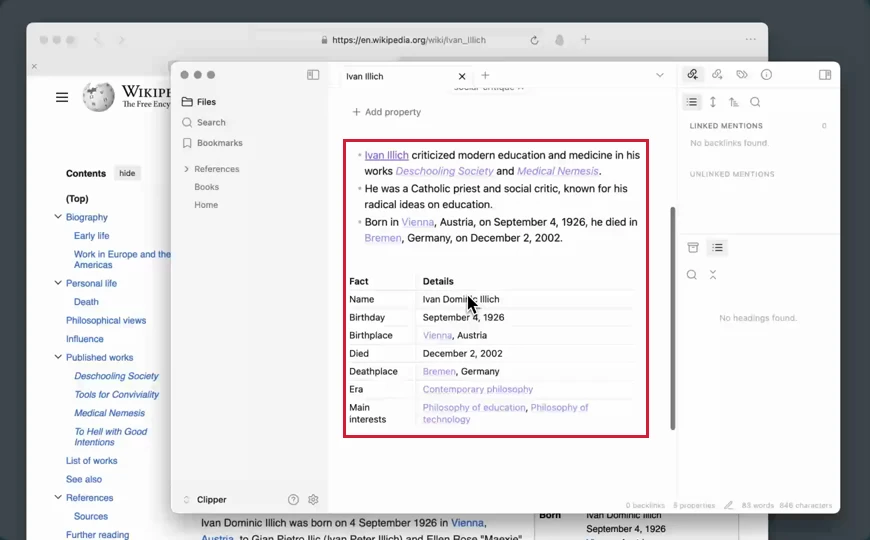
图 4 Obsidian 中保存的条目摘要和事实表
日常整理可以固定保留标题、网页原址、采集日期、要点和待核对项。每个主题沿用一份模板,回顾时按同一组字段对照各篇网页。遇到表格缺行或正文没有采全,先确认剪藏范围,再补录缺失段落。
-
专题
三国战纪-风云再起 整合版
-
专题
三国战纪-乱世枭雄
-
- AI搜索会编造来源吗?打开引用后怎么核对
- 11.07
-
-
- AI研究结果互相冲突?先核对统计口径
- 11.07
-
- AI搜索引用打不开怎么办?两款工具如何核对原文
- 11.07
-
-
下载
- |
-
-
下载
- 《行尸走肉第一章》免安装中文汉化硬盘版下载
- 单机|436 MB
- 一款以动作冒险为主题的游戏
-
-
下载
- 《街头霸王X铁拳》免安装中文汉化硬盘版下载
- 单机|111MB
- 一款非常好玩的格斗游戏
-
-
下载
- |
-
-
下载
- 《暗黑破坏神3》免安装繁体中文正式版下载
- 单机|7630 MB
- 一款以角色扮演为主题的游戏
-
-
下载
- 《马克思佩恩3》免安装硬盘版下载
- 单机|27033 MB
- 一款以第三人称射击为主题的游戏