Gartner 说的“开放模型”到底指什么?开放权重与完整开源的区别
Gartner 谈到的开放模型,通常需要按开放权重来理解:企业可以取得模型参数,在许可证允许的范围内运行和调整。它不等于完整开源 AI。训练代码、数据相关信息和使用权利是否充分开放,仍须分别判断。
权重开放,究竟开放了哪一部分?
权重可理解为模型训练后形成的数值参数。拿到权重,再配合架构配置、分词器和运行软件,通常就能搭建推理服务,不必把每次请求都发送给原厂 API。企业也可能进行量化、微调或部署优化,但这些操作是否被允许,要看相应版本的许可证。
它没有自动交出训练过程的全部信息。仅靠参数文件,不能完整还原预训练语料、清洗规则、实验记录和数据授权。权重可见,也不等于每一个输出都能解释清楚,模型对某道题的回答仍可能出错。
完整开源 AI 多了什么要求?
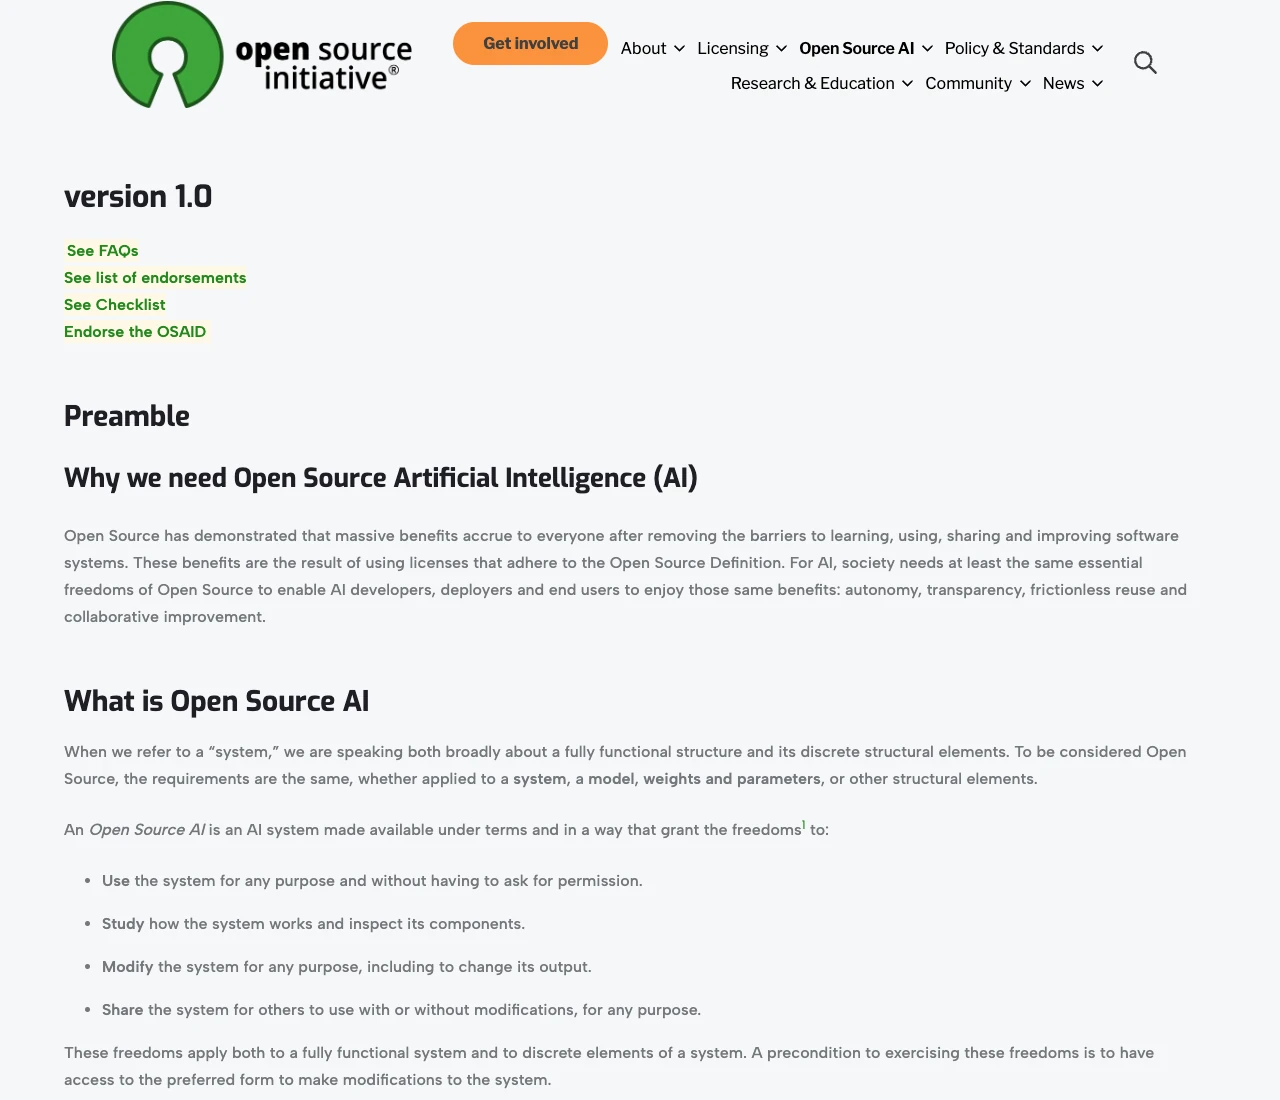
OSI 的开源 AI 定义不仅关注能否下载,还关注使用、研究、修改和分享的自由,和修改系统所需的适当形式。对机器学习系统,这涉及参数、代码与足够的数据相关信息。它并不简单等于“必须公开互联网上每一条原始训练数据”,也不是贴上一个开源软件许可证就自动满足。
| 常见说法 | 通常能得到什么 | 仍需确认什么 |
|---|---|---|
| 开放 API | 通过接口调用服务 | 权重一般不能下载,服务条款另行约定 |
| 开放权重 | 取得参数,自行运行的可能性 | 商用、修改、分发和规模限制 |
| 开源 AI | 满足相应开放定义的组成与权利 | 完整交付内容及许可证是否符合要求 |
为什么企业会在意这个区别?
若采购目标是让数据留在自己的网络里,权重可下载且允许自建,可能已经解决一部分问题。若目标是独立复现训练、审查数据来源或把改进版本再分发给客户,要求就更高,不能只看模型介绍中的“开放”两个字。
还有一种容易忽略的情况:企业调用的虽然是开放权重模型,但实际使用的是第三方托管 API。数据经过哪里、日志保留多久、服务中断如何处理,仍然由托管方式和合同决定。模型开放不等于这次调用已经变成本地处理。
采购时把问题问相应
要求供应方列出精确模型名称、版本、权重下载方式、许可证、运行依赖和数据处理路径。软件代码、模型权重、数据集和托管服务可能分别使用不同条款,应分开保存。不宜用同一个品牌下某个小模型的许可,替代另一个大模型的商业审核。
实际交流中可继续使用“开源模型”这一常见简称,但在采购、法务和部署文档里,应明确写成开放权重还是符合某项开源定义。把权利和交付内容写清楚,比争论名称更能避免后续返工。
-
专题
三国战纪-风云再起 整合版
-
专题
三国战纪-乱世枭雄
-
-
下载
- |
-
-
下载
- 《行尸走肉第一章》免安装中文汉化硬盘版下载
- 单机|436 MB
- 一款以动作冒险为主题的游戏
-
-
下载
- 《街头霸王X铁拳》免安装中文汉化硬盘版下载
- 单机|111MB
- 一款非常好玩的格斗游戏
-
-
下载
- |
-
-
下载
- 《暗黑破坏神3》免安装繁体中文正式版下载
- 单机|7630 MB
- 一款以角色扮演为主题的游戏
-
-
下载
- 《马克思佩恩3》免安装硬盘版下载
- 单机|27033 MB
- 一款以第三人称射击为主题的游戏