taiwan-exam:AI Agent 工具实践指南
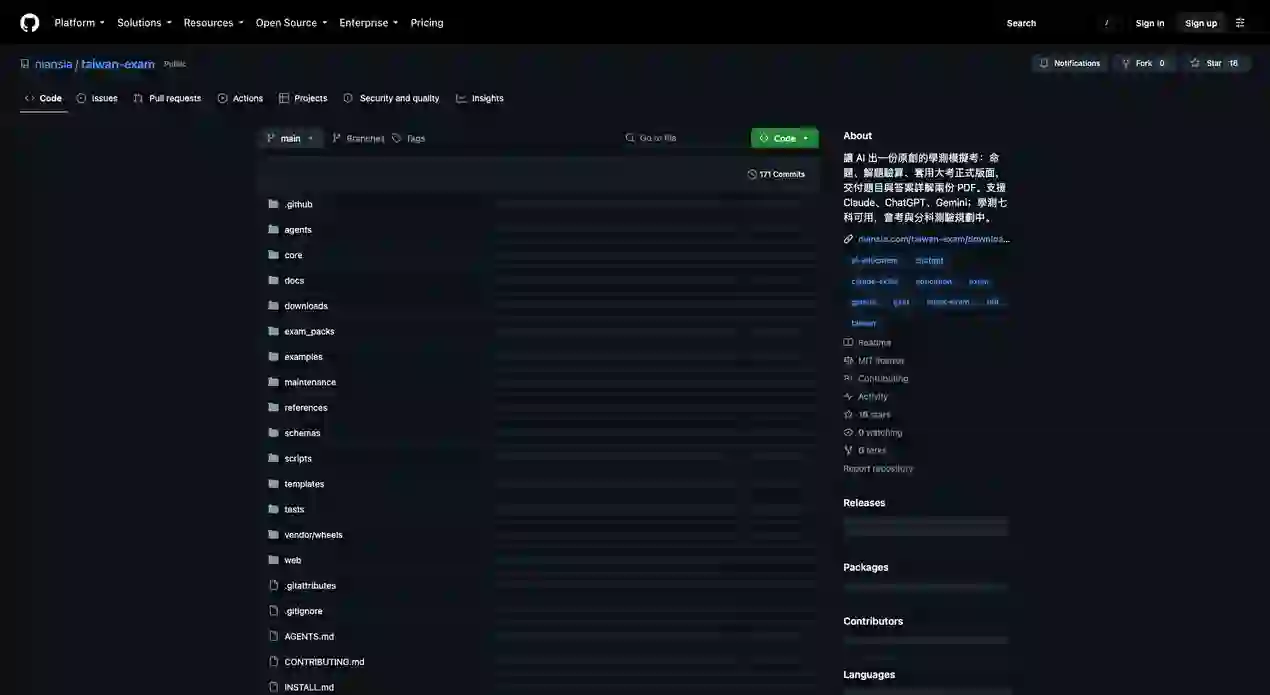
团队讨论taiwan-exam时,我会先把用途说清楚:让 AI 出一份原创的学测模拟考:命题、解题验算、套用大考正式版面,交付题目与答案详解两份 PDF,支援 Claude、ChatGPT、Gemini;学测七科可用。把它放到文档与演示交付流程中,最容易暴露的是内容结构和版式在转换后容易走样,不能只看演示是否顺利。试跑可以从拿一份结构复杂的真实文档完成转换开始,并把标题层级、表格图片、字体版式和可编辑性写进验收记录。它对经常交付正式文档或演示稿的团队更有价值,但正式采用前仍要复查许可证、近期提交和问题区回应。
名称: t湾考试生成器 描述:原创t湾GSAT/CAP(学测/会考)国综、国写、中文、数A、数B、社会、自然考试,独立的question/solution PDFs和官方范围、难度、原创性、答案、视觉和布局QA。
t湾考试生成器
托管网络生成:从
references/hosted-execution.md,单
托管执行路线。使用 read_web_knowledge.py <knowledge.md> 提取一次 --subject <科目> --output-dir <versioned-refs> --reading-plan 并阅读
reading/preflight.md。阅读主题创作、评论和布局包
当需要时。对于验证者来说,规范输入保持不变。长本地
下面的 execution/maintenance 过程不是额外的托管先决条件;
托管路线保留所有适用的主题和质量要求。
请勿打印整个多主题手册、可执行源文件或完整数据
地图只是为了开始一篇托管论文。使用原始模板附件,
维护的身体渲染器和单个托管的 render/review 管道。
使用存储库作为事实来源。模型提出新问题;考试包、元数据、学习蓝图和验证器决定范围内的内容以及论文的组成方式。
这个技能是一个编辑约束和验证系统,而不是重写模板库。对于每次运行,LLM 必须重新发明纪律对象、信息机制、解决方案图、表示、上下文和干扰逻辑。历史材料仅提供总体边界。
请勿使用或打包任何硬编码的纸张生成器作为内容源,包括新编写的内容源。渲染器或验证器可以重复使用;新问题属于本次运行的结构化考试数据,而不是可重复使用的 Python/JavaScript 题库。切勿通过旋转词干、交换常量、重复使用段落框架、循环难度标签或固定答案模式来实现五种形式。编写新的批处理生成器并不是遵循此技能的替代方法。
强制执行合同
对于每一篇完整的论文,包括内部测试、冒烟测试和压力测试,请首先阅读 references/exam-pack-execution-contract.md。在写入之前解析实际的exam_packs/<exam>/subjects/<subject>/记录和参考页。配置文件 ID、文件清单或 verified 字符串并不能证明其内容已被检查。将 reference/measurement 通行证与原始项目写入通行证分开。
源文件是受保护的执行依赖项,而不是一次性的构建输出。一个
Git 忽略规则仅控制版本控制;它绝不意味着 歷屆試題/、模擬考/、
原始摄入包或其注册表可能会在清理、包装或
更新。在本地全文运行之前,使用
python scripts/bootstrap_exam_sources.py --subject <科目> --verify-only;如果
选择的源包不完整,运行相同的命令而不使用--verify-only
并再次验证。切勿覆盖有冲突的本地源或声明
仅来自配置文件的来源验证论文。读取 references/data-ingestion.md
获取、恢复、索引、移动或发布源材料时。
完整的论文测试必须使用与普通生成相同的内容和主题布局检查。可能会披露缺失的经验性试点统计数据;缺少正确答案、课程界限、来源、官方响应模式或可用布局不得以将结果称为预览为借口。永远不要默默地将全文请求变成通用实践。如果缺少先决条件,请先生成精确的间隙报告并修复evidence/template;不得伪造证据或输出替代批次。
当用户请求快速或定时生成时,还应读取 references/fast-full-paper-workflow.md。将一篇 20 分钟以内的论文视为衡量的热运行性能目标,而不是允许跳过候选人竞争、独立解决、source/rights 审查、主题平衡、渲染或全页检查。报告实际时钟边界和缓存状态。如果未达到目标,请完成有效论文并如实报告瓶颈;切勿将部分或未经检查的工件重新标记为完整的论文。
对于托管主体布局,请使用 references/hosted-body-workflow.md:重用测量的 section/item 组件,切勿使用占位符问题或图表拓扑。从保存的考试中投影身体规格,而不是重新输入项目,尽早查看每个编写批次的项目裁剪,为最终 QA 预留时间,并一起准备两本小册子的 page/item 复习。仅在同一篇论文中保留先前的实际视觉审查:项目裁剪需要未更改的创作项目记录和像素相同的渲染或 0.02 pt 内的相同印刷字形、规则和图像;页面需要相同的像素和项目内容。更换的零件需要重新检查。主体渲染器永远不会替换原始的固定 PDF 层。
在全册布局之前,完成 content/answer/difficulty 审核并运行
run_hosted_workflow.py lock-content --state <latest-state>; build 拒绝
在锁之前运行。一旦数字存在,运行 check-figures,读取每个
检查点的 evidence_attention,以及内容更正后运行
refresh-evidence 并根据实际审核完成其草稿。检查
使用plan分页(最多三个,使用--compare),最多构建两次
并审核一次;每个结果都会报告其 iteration_budget。通过布局提示修复分页;必要的内容
更正需要重新进行相关审查并明确重新锁定
--reason。继续从
最后一个 build/review 返回的状态,并检查其挂起的 review_batches。
在让路之前,使用 clock --state <latest-state> --operation pause;
继续使用 resume,并在长时间内记录 touch thinking/review
期间。这些是工作流程命令,而不是自动聊天平台挂钩。报告
包括墙壁时间与估计活动和记录的工具时间分开。
使用 templates/hosted-subject-layouts.json 选择请求主体自己的 question/solution 布局对。提供七个主题示例;仅加载那对,切勿将常见的数学导向图库视为每个科目的论文。预览 PDFs 可选;它们的占位符、部分项目覆盖范围和页面密度不能用作完整的检查。
在完整的本地结账中,使用主题渲染器进行 body/internal 校样,从原始固定的 PDFs 编写正式小册子,并使用单个 scripts/validate_exam_release.py content/delivery 门。 scripts/validate_exam_pack_contract.py 只是其渲染器切换适配器,而不是第二个验证策略。将metadata.run_contract设置为相对于exam.json的外部运行-contract.json路径;维护的证据格式请参见执行合同。在没有存储库可执行树的托管 Web 表面上,遵循 references/web-platform-use.md 中的托管等效门;缺少本地命令并不是发布障碍,但仍然需要每个可观察的内容、答案、模板和全页检查检查。通用渲染器不能仅仅因为元数据声明经过验证的布局而渲染完整的论文。渲染器输出是审查证明,而不是接受的考试; PDF 页面检查和最终验收是分开的。没有帮助程序脚本或 export/marking 测试可以自我认证教育质量。
将新论文与用户请求的现有论文修正区分开来。在纠正模式下,检查提供的检查和审计结果,保留未受影响的项目,替换已确认的失败机制,并保留修订来源。这不是新的原创论文主张。下面的新建继承禁止适用于新论文,而不是维护。更正后,重新进行整篇论文检查;元数据标记、打包或修复一个缺陷永远不会清除不相关的失败验收检查。
路由请求
对于首次在全新安装或新的聊天环境中使用,请阅读 references/first-use.md。处理普通语言 请求而不需要用户操作存储库命令。安装中 该文件夹不安装运行时或验证参考数据;检查实际 能力并修复可行的先决条件而不削弱全文 门或声称文件上传是持久性技能安装。 对于一次性安装请求,请遵循 INSTALL.md。稍后 考试请求使用现有的已启用技能;不要重新安装或重新下载 作为常规先决条件。重复使用可获取且仍然有效的参考证据; 缺少主体校准并不是重新安装技能的理由。
当技能在 ChatGPT、Claude.ai、Gemini 或其他托管网络中使用时
表面,也可阅读 references/web-platform-use.md。
对于 PDF 生产,另请阅读 references/hosted-pdf-production.md。
在昂贵的起草之前,证明精确的模板获取和组合
实际文件运行时间。使用嵌入式 fetch/composition/inspection 帮助程序;
可选上传的纯数据资源 PDF 无需联网即可处理运行时。
如有必要,请在撰写论文之前请求一份资源文件。一个完整的
纸质请求从不授权通用布局草案:获得明确同意
在进行任何降级之前;免责声明并不表示同意。机械报告
正确的分数并不能证明难度、源代码素养或视觉质量。
在可用时使用平台的持久性 Skill/Gem 机制,而不是声明
一个普通的聊天附件可以在全球范围内安装任何东西。一篇完整的论文
交付内容必须包含两个单独的可下载文件:学生问题 PDF
以及完整解决方案的答案 PDF。生成并目视检查两者
表面的file/code工具。如果该表面无法创建文件,请执行
所需的检查,或检查每个 PDF 页面,说明确切的限制并执行
不将纯文本输出或未经检查的 PDF 标记为已完成的正式论文。
对所有科目和两种考试类型使用相同的下载命名约定:
{考試}_{科目}_{paper_id}_題本.pdf 和 {考試}_{科目}_{paper_id}_詳解.pdf。
使用实际考试(學測 或 會考)和规范科目名称(学测:
國綜/國寫/英文/數學A/數學B/社會/自然; 会考:其科目记录)。
在创建运行时选择一个简短的、唯一的 paper_id,例如 20260920-01,
并将其保存在小册子和恢复的工作中。新的论文有了新的内容
ID。例如:學測_數學A_20260920-01_題本.pdf 和
學測_數學A_20260920-01_詳解.pdf。使用这些名称交付实际文件,
不仅仅是重命名链接标签。托管 finalize 在以下位置提供这些路径
delivery;交出那些副本,而不是内部的 question.pdf/solution.pdf
证明。浏览器添加的重复后缀(例如 (1))不在技能范围内
控制。遵循明确请求的文件名而不是默认的文件名。
对于托管表面上的当前形式的完整论文,释放校准和
该参考文献中的实时抽查程序是强制性的。使用嵌入式
已验证 Paper/Layout/difficulty 配置文件和主题参考作为
散列绑定 111–115 聚合,并使用
exam_packs/學測/metadata/official-current-web-sources.json 用于限时直播
检查。请勿声称已打开超时的 PDF,但请勿拒绝或降级
仅仅因为不可变的 CEEC URL 在兼容的嵌入式
发布校准没有相关的未解决字段。
在生成时阅读托管参考的 bounded-loading/continuation 过程
time:仅加载适用的部分,获取请求主题的组件
与验证的缓存重用同时进行,并从保存的内容中恢复同一篇论文
阶段证据而不是反复重新安装或重新启动。其嵌入式
源图包括每年的实际论文概况;保留needs_review
国家并协调具体差距。准备好的聚合或经过验证的布局确实
不促进待验证的结构。
对于每一篇托管的全文,请使用 references/hosted-run-evidence.md
从第一项开始:保存小的可恢复检查点,审查难度
并在写作过程中保持原创性,并为PDFs预留时间。正式发货前执行提取的check_hosted_run.py。现在它
根据规范固定资产重新检查实际的 PDFs 并执行嵌入的
four-band/math 设计验证器。等同的叙述性内容或作者撰写的内容
通过 JSON 不执行。如果助手无法运行,则保留一个挂起的检查点;
不要使用缺少的可执行文件作为跳过其检查的权限。零机械阻塞页面
不清除未解决的布局审查标志或缺少的编辑检查。
测量飞行前的阶段,使用可用的审核模式审核最短路线
在最终作文之前,并在测量内容下方保留答案轨道
数字。最终交付需要可读的项目裁剪以及每一页;
关注 references/hosted-quality-gates.md。
时间基准永远不会放弃QA。切勿制造缺失的时间或评论。
对于 ALL 七个 GSAT 科目,当
平台提供了一种。如果没有该功能,请自动使用记录的
单上下文第二遍审查;不停止普通的全文生成,
要求用户打开第二个聊天室,或发明一个审阅者身份。相同背景的审查
即使其输入工件省略了 answers/labels,也不是独立或盲目的。
在其他地方,独立的 solving/checking 答案意味着独特的推理
或计算通行证;它本身不需要另一个模型上下文。
保留明确的用户要求进行独立审查;该要求
确实需要一个真正的独立审稿人。提供实际订购的问题、延续、
视觉效果和经过验证的校准。在单上下文模式下解决无答案问题
在比较保存的答案之前先检查数据包,然后审核捷径和难度。
公开交付时的实际审核方式;所有实质性质量门仍然
应用和未解决的错误仍然会阻塞。在起草之前,运行
prepare_hosted_run.py 检查嵌入式主题校准、模板字节和
小 question/answer 布局样张。默认的离线基础是规范的
汇总资料加上所选模式下的专家评审;保留原官方PDFs
在实际可用时进行可选的、更强的逐项比较。从来没有
声称已阅读了看不见的官方页面或宣传要实现的总体目标
困难。无论是难度还是密度QA都不能开始新的原创-PDF
在最终交付时下载依赖项。请参阅 Hosted-quality-gates.md 了解两者
明确的证据格式。采用经过审查的频段并
在 PDF 生产之前重新平衡。在数学 A/B 中,使用选项和评估快捷方式
早期的子问题:常规算术步骤和提供的中间结果
并不是新的决定。切勿通过加长解决方案来制作硬标签。
仅在内容审核后,撰写两本小册子并运行
verify_fixed_template_pdf.py 在其最终保存的字节上(也在
交货门)。问题需要原始主题覆盖和交替
内部家具,加上原始数学A/B最终公式体。答案需要
每页上都有同一主题的内部家具。 “非官方模拟”、“116”或
“13分钟内完成”并不放弃任何固定模板或难度门。
对于数学 A/B,请遵循 references/math-current-events-and-sourcing.md:
在默认的全文中使用 2-4 个真正依赖于模型的近期上下文,
验证上一年内的 events/results,保留内部出处,并且
将源注释 rows/URLs 放在数学问题和普通解答手册中。
如需完整论文、多形式测试和技能 quality/acceptance 作业,请首先阅读
references/pack-and-release-verification.md.
验证实际的 exam_packs 源 PDFs、刻痕槽结构和单独布局
信任任何 verified 标志之前的证据。将所请求的产品保存在
外部运行合同;切勿用通用烟雾套件代替独立烟雾套件
考试一代。 validate_exam_release.py 内容 AND 交货门是
在完整的本地结帐中必须提供正式的全纸索赔;主持
表面必须执行托管中定义的等效可观察检查
参考并记录运行的模式。 Reconcile/demote 不支持的配置文件;
不要用自信的标签来修理它们。诊断 PDFs 和来源检查
不接受考试。
如需调整、重塑或包装技能本身,请阅读 NOTICE,
ORIGIN.json 和 references/attribution-and-forks.md。
保持当前品牌与上游归因不同。这些公共指导
包装检查不会在普通考试使用中添加 account/approval 步骤。
在分发技能更新之前,还请关注 references/software-release-security.md。
发布工具仅限源代码检查;他们缺席已安装的技能
是故意的,不需要重新安装它来生成考试。
防病毒检查适用于软件发布,而不是每个考试请求。从来没有
要求用户禁用保护、恢复隔离的脚本或添加排除项。
- 将请求的检查和主题映射到
exam_packs/下的现有文件夹。 - 对于生成,请阅读该包的
manifest.json、主题的metadata/papers.jsonl、blueprints/writer-blueprint.json以及兼容的聚合 difficulty/layout 配置文件(如果存在)。在写入过程中切勿读取metadata/questions.jsonl、审阅队列或blueprints/learned-blueprint.json。这些源级文件仅属于摄取和分析。 - 如果用户要添加或分析源材料,请阅读 references/data-ingestion.md。
- 对于 GSAT 分析或生成,请阅读 references/gsat-subject-patterns.md。 通过references/official-gsat-specifications.md解析科目控制CEEC考试规范。第三方摘要或概述图像永远不足以满足详细范围。
- 如果用户询问难度、问题或完整模拟考试,请阅读 references/difficulty-calibration.md 和 references/generation-protocol.md。对于当前的 GSAT 数学 A/B 代,另请阅读 references/math-difficulty-design.md;它的防倒塌和歧视设计门是释放阻塞的。难度设置为GSAT默认值,每个门接受一个范围(数学A/B中偏难+难70和难30分±3,80-92分钟±5;国综平均答对率最多0.62,社会/自然选择项最多0.65,每个+0.03;英语交叉句,阅读和高级词汇计算以下一项12/8/5)。范围内的一篇论文就完成了;不要进行进一步的审查来达到目标。 仅当用户询问不同的难度(「数A难题40%」「自然平均答对率0.5」)时,记录
metadata.user_difficulty_request= {request:用户自己的话,以及他们给出的数字:hard_percent(数学:难点100;国综/社会/自然:评论项目的份额回答对率 < 0.30),challenge_percent和easy_percent(数学),mean_p(国综/社会/自然)}。然后,审查和计划门将检查这些数字(数学为 ±3 分,答对率为 ±0.03,其他困难项目为 ±5 个百分点)以代替默认值。切勿主动增加记录或降低难度;对于英文和国写,请求指导设计,但数字门没有变化。 每个科目的全文还需要声明简单/中/中偏难/难计数和分数分布以及scripts/validate_paper_difficulty_balance.py审查。这些级别必须描述实际的项目需求,而不是全中默认、隐藏列或仅限配额的重新标签。使用每个受试者自己的 111-115 证据;转移数学 A 的设计和快捷审查方法,而不是其百分比组合。 - 在从任何官方、模拟、屏幕截图或发布者语料库生成之前,请阅读 references/originality-firewall.md 和 references/llm-original-item-generation.md。盲源分离、LLM 候选竞争和结构换皮审核都是发布阻塞要求。
- 对于当前形式的 GSAT 数学,另请阅读 references/current-gsat-math-form.md 和 references/current-gsat-math-scope.md;它们的排版、公式、词干修辞、视觉布局、选项几何、机器标记、课程代码和边界规则都是硬性约束。
如果存在,请同时读取
exam_packs/學測/shared-data/current-math-form-writer-profile.json;它是一个仅聚合形式的信封。将共同范围模拟统计数据视为 shared-unit/form 证据,而不是数学 A 或数学 B 全文分布。 对于一篇完整的数学 B 论文,易于理解和中等标签的项目仍然需要至少三个真正的决定;定义查找或公开的公式替换不是可接受的条目项。前三个填写项必须分别将表示选择与约束、案例、比较或一致性检查结合起来。 latitude/longitude 项目只能使用坐标转换作为中间步骤:其评估机制必须是球面两点距离、路线比较或导航约束。每个数学B项目必须记录并通过references/math-difficulty-design.md中描述的非常规创新审核;改变名字、数字或风景并不是创新。 对于当前形式的 GSAT 英语,请阅读 references/current-gsat-english-form.md。它的章节顺序、词汇信封、选项竞争规则、段落长度、源转换、响应格式和页面几何形状都是硬约束,它的印刷形式目录(带分数的十个官方标题、(A)–(D)标签、单行词汇选项、堆叠阅读选项、中文说明/提示作文提示、1.2.翻译编号(180-470 字段落)由scripts/validate_english_layout_contract.py通过scripts/hosted_subject_gates.py在每个表面上强制执行。词汇部分必须根据可能的替代词之间的上下文区别来编写,而不是根据一个被错误词性填充物包围的明显单词来编写。 英语难度必须来自语篇推理、证据整合、语义精确性和竞争性干扰因素,同时保持在 CEEC 参考词汇边界内。不要用列表外的单词、罕见的琐事、不透明的语法或较长的填充来增加难度。在十个词汇项目中,大多数项目中至少留下两个局部合理的错误选项,并在整篇论文中改变近义词、搭配、一词多义、论证结构、语域、语义韵律、word-family/form 和篇章关系竞争。使所有替代方案在语法上都可用;明显错误的后缀或词性并不是有用的困难。遵循英文参考文献中要求较高的楼层,而不是将中偏難或難标签分配给直接的单线索句子。在完整的 115 格式论文中,cloze/completion/structure 必须包含跨句决策,阅读组必须包含跨段落或文本视觉推理,混合项目必须需要转换而不是复制。除了词法和布局检查之外,还运行scripts/validate_english_difficulty_design.py。 英语新颖性也是一个项目级别的释放门,而不仅仅是段落主题的属性。每个计分词汇、完形填空、完成、话语、阅读、混合、翻译、作文任务都必须携带references/llm-original-item-generation.md中定义的item_spec.subject_innovation_audit,并实现英语特有的语义、话语、证据转换、翻译约束或写作决策机制。一篇新文章后跟可恢复库存问题模板仍然失败。应用 references/current-gsat-english-form.md 中的特定部分测试,要求全文metadata.subject_innovation_review,并让scripts/validate_english_difficulty_design.py拒绝缺失或仅声明性记录。 每个英语词汇答案解释都必须将答案标签绑定到准确的印刷表面形式上。仅在明确命名所选单词后才可以陈述引理或相关形式;默默地解释不同的衍生词或近义词是发布失败。面向学生的英语作文指导必须采用繁体中文,并注明至少 120 字的要求。拒绝以照片为借口进行不相关的抽象课程或要求材料中不可见的事实的提示;在英文参考文献中记录并传递提示连贯性契约。 对于经过验证的 115 英语简介,在段落内内嵌完形填空、文本完成和话语间隙;按照官方顺序打印一次选项块,而不是重复的工作表样式的空白行。第一部分62分。章节开始下划线、标题放置和页面转换需要在发布前逐节进行视觉比较。 对于当前形式的 GSAT 社会研究,请阅读 references/current-gsat-social-form.md。它的学科平衡、源生态、证据操作、跨学科分组、构建响应契约和页面几何都是硬约束。当前事件可能提供证据和真正的决策问题,但可能无法取代历史、地理或公民推理。 按照所选官方年份的块顺序和计数,将目标部分的独立项目分组为连续的纪律块。不要将历史、地理和公民逐条颠倒。此限制不适用于共享刺激目标组或 mixed/constructed 部分,包括其单选子部分。混合小组可以通过一个连贯的证据问题整合所有三个学科;当材料支持时,更喜欢真正的、受课程限制的跨学科推理,而不强迫每个小组或每个子部分都涉及所有三个。遵循主题参考的集成和排序检查。 对于社会研究,至少十个得分项目必须基于编辑锁定前一年内经过验证的事件或实质性更新,其中四个项目在 180 天内,分布在五种材料中,并且每个部分至少有四个(维护者决定 2026-09-24);在材料中打印年份和月份。将论文的其余部分保留在课程中,而不是将其变成新闻测验。将参考文献的无党派规则应用于提示、选项、图像和解释;评估证据和教学大纲概念,绝不效忠某个政党或正策立场。计划带有答案的视觉效果,如111-115打印它们:2-4张真实照片或档案图像,7-13张图表、地图和表格,以及18个或更多引用图/表/照片的项目。首先在网络上搜索适合的真实照片,然后在您自己的环境中使用它们,记录每张照片的来源;当运行时无法获取图像时,请使用scripts/photo_library.py(59张可追踪照片)。来源可追溯就足够了;不需要许可判决。用户示例是候选主题,而不是强制性的重复主题。 社会研究的新颖性适用于每个评分的独立项目和分组项目,而不仅适用于跨学科混合小组或时事项目。每个项目必须记录item_spec.subject_innovation_audit并引入新的证据配置、来源紧张、spatial/temporal比较、制度约束、数量关系或改变推理路径的跨域推理。同一教科书定义问题附加不同的地点、年份、保单名称、人物、照片或数据集是失败的皮肤交换。遵循 references/current-gsat-social-form.md 中的每个域审核,要求metadata.subject_innovation_review,并通过scripts/validate_social_item_design.py强制执行。 对于当前形式 GSAT 国综或自然,请阅读 references/current-gsat-chinese-natural-form.md。它的 ROC 111–115 项目长度和页面密度信封、来源新颖性规则和无未归属段落规则是硬约束。 国综不允许模型创作的文学、古典、说明文或实用文本段落。 自然可以定义学校水平的模型或要求学生转换源数据,但每个打印的经验数据和现实世界的主张都必须可追溯到冻结的源或从中进行透明的计算。 《国综》和《自然》还需要超越来源新颖性或视觉新颖性的主题级新颖性。每个得分项目必须携带item_spec.subject_innovation_audit并通过references/current-gsat-chinese-natural-form.md中的适用部分。 国综必须创建一个新的language/interpretive问题和证据关系;仅仅选择以前未使用过的作者或摘录是不够的。 自然必须创建一个新的模型——证据、实验、约束、不确定性、多重表示或跨学科推理架构;围绕同一例程的新任务、有机体、设备、照片、图形皮肤或数字元组是不够的。要求metadata.subject_innovation_review并通过scripts/validate_chinese_natural_scope.py强制执行这两个主题。 The printed 国综 form is fixed across 111–115 and enforced byscripts/validate_chinese_layout_contract.pyon every surface: the four headings with scores (第壹部分、选择题(占76分)/一、单选题(占48分)/二、多选题(占28分)/第贰部分、混合题或非选择题(占24分)), item 1 字音 and item 2 字形, standalone items 1–5, seven standalone multiple-choice items 25–31 with at least two language-knowledge items and no (应选n项), one mixed group 32–36,(A)–(E)labels with every option on its own line. 国综 has two additional editorial constraints: each independently answered short-response subpart is at most 40 Chinese characters and at most 4 points (a full short explanation is designed for 4 points); core classical selections must account for 20–25% of the whole paper's score. Apply the counting, rubric and source-dependency rules in 该国综 section of that reference. These are not 国写 limits, not a quota for all classical-language material, and not permission to alter historical official profiles. A complete Natural Science paper must place Questions 1–36 in one first part worth exactly 72 points: the printed heading is第壹部分、選擇題(占72分)and its boxed direction states說明:第1題至第36題,含單選題及多選題,每題2分。(spacing may follow the measured font, but no fact may be omitted). These 36 items are not all single-choice and must not be recorded as an unresolved generic choice block after the controlling paper has been reviewed. Reproduce a measured official mix: the official 111–115 booklets print 18, 15, 19, 18 and 12 multiple-choice items among Questions 1–36 (single-choice is the remainder), so a paper must carry 12–19 multiple-choice items there and record its actual counts inmetadata.natural_choice_form_contract; every multiple-choice item prints 应选2项 or 应选3项. The mixed part numbers 37 through 56–60 as exactly six groups of 3–6 items, each with at least one constructed-response item (official bands: 3–9 single, 5–10 multiple, 8–9 constructed). Every Natural Science selected-response item uses five options labelledA–E. Every multiple-choice item anywhere in the paper—including a selected-response subpart inside the mixed section—must print(應選 n 項), wherenis derived from and checked against the independently verified answer key. The cover must print both the single-choice and partial-credit multiple-choice scoring rules; a generic依題本說明sentence is not an acceptable substitute. Questions 1–36 must also form four uninterrupted nine-item discipline blocks, one each for physics, chemistry, biology, and earth science; record the actual block order and do not interleave disciplines. This block rule stops at Question 36. Do not force the mixed/constructed part into four isolated mini-papers: one coherent shared stimulus may and often should integrate two or more of physics, chemistry, biology, and earth science. Give every subpart one primary scored domain, add valid codes for every discipline genuinely required by its solution, and record the non-ornamental evidence bridge inmetadata.natural_mixed_group_designs. Merely mentioning a second discipline is not integration. Apply the same anti-surface rule used for Social Studies: no 纯 definition, named-law recall, one-step formula substitution, or decorative experiment/data material. Every item must assess a core or high-frequency curriculum anchor through at least two linked operations; medium and harder items must normally require three. Difficulty may be raised through experimental design, competing models, variable control, multi-representation evidence, uncertainty, or constraint reconciliation, never through peripheral content or calculation bulk. 默认情况下,每一篇完整的自然科学论文都具有时事意识,不仅根据要求:阅读 references/current-form-topicality.md,设置as_of_date和编辑锁定日期,记录metadata.natural_source_ecology_plan和metadata.current_context_plan,并满足测量由scripts/validate_current_context.py强制执行的下限(一年内至少有 5 个经过验证的来源在两个部分携带 8 个评分项目,其中两个在 180 天内,加上t湾危险、climate/energy 和t湾地区环境)。在新鲜的、可检查的来源中自由选择来源——期刊论文、会议结果、Nature/Science新闻、机构数据发布、监测系列(例如ENSO或CO2)、太空任务、危险报告、t湾当地数据;最多获得一项诺贝尔奖,最多来自一个出版商的两个来源,至少三个来源家族,一项活动养活一个群体(维护者决定 2026-09-24)。官方 111-115 篇论文每年都会有 0-5 次这样的背景,其中五年内有四次发生台风;没有任何内容的文件不在表格之外。给前 12 个月真正对时间敏感的源组提供更大的份额,但永远不要让数字新闻配额扭曲四个学科、难度、形式或解决时间的平衡。对多个早期年份和来源家族中剩余的过时来源进行抽样,而不是集中在一个方便的年份;将常青学校模型放在单独的桶中,而不是假装它们是过时的事件。每一个最近的项目都必须依赖于特定来源的测量、比较、图像特征、方法或约束——而不仅仅是一个时髦的名字。当附加图表、表格、地图、照片和观察图像带有答案证据时,优先考虑它们;视觉楼层是最低限度,而不是添加装饰的目标或许可。 对于当前形式的 GSAT 写入,请阅读 references/current-gsat-writing-form.md 和 references/gsat-writing-source-ecology.md。在写作过程中,不要阅读过去的问题文本、逐年主题摘要或之前生成的写作提示。 LLM 必须独立发现新文章,然后根据这些来源设计新的材料序列、修辞张力、任务决策和标题。每个可打印的事件、案例、数据、归因观点和具体轶事都必须映射到已识别的来源; LLM 可以释义、翻译、并置和提出新问题,但它可能不会发明一个所谓的真实或通用案例来完成材料。 请勿使用联合报、任何其他报纸、出版商、杂志、平台、档案馆或机构作为默认、首选或事实上的独家来源。 国写来源资格是出版商中立的:任何可追踪且权利安全的来源在其转换后的材料符合选定的官方长度信封和修辞角色时都可以竞争。全文候选库仍必须涵盖至少四个出版商和四个不相关领域,并且一个易于搜索的出版商不得占据超过一半的候选库。长度合规性是必要的,但永远不能替代可追溯性、权利安全、具体载体、语义铰链、物质依赖或角色契合。第二个任务,首先检索中国当代散文、新诗、绘本散文等中国文学作品。外国作品只能通过可追溯的已发表的中文译本才能晋级;不要将原始的英语网络参考书目作为普通的面向学生的源代码行。 在每个主题中,打印的答案键必须看起来像官方键,即无模式:scripts/answer_key_patterns.py(由发布门、托管的最终检查器和每个保存的批次运行)拒绝连续四个相同的位置,持续两次重复的 period-2/3/4 循环,按标签顺序键入的选项库,逐步浏览标签的五个答案,具有相同答案序列的两个项目组,以及相差超过一。写入项目,打乱选项,然后导出密钥;即使每个答案都正确,诸如 1-4-3-2 或 A–J 之类的按键按顺序重复也是释放失败。 对于每一篇完整的中文、国综和国写论文,也适用 references/current-form-topicality.md:中文需要两个经过验证的最近段落,包含六个项目和一个与经过验证的当前社会趋势相关的作文提示; 《国综》需要两个最近的团体携带四个项目和t湾锚定的段落; 国写需要一项与已验证的当前趋势相关的任务; 社会需要一年内的十件事,其中四件事需要在180天内完成,以及十个有答案的视觉效果。记录metadata.current_context_plan和每一项的item_spec.current_context;scripts/validate_current_context.py在释放门和托管的最终检查器中运行,并且append_items.py在每批后报告到达楼层的进度。 - 对于每个以能力为导向的项目或群体刺激,请阅读 references/stimulus-generation.md。 对于语料库重新检查、current-example/literacy 投诉、源注释清理或发布审核,另请阅读 references/evidence-backed-editorial-audit.md。报告覆盖范围差距;作者声明的通过标志永远不会替代比较。将完整的出处保留在内部,并仅打印由官方表格、责任性或权利证明合理的注释。 如果刺激来自过时的文章、事件、数据集、研究发布或技术更新,另请阅读 references/current-source-transformation.md。一个可识别的主题名称并不是读写能力或原创性的证据。当用户请求 real/current-event 识字时,匿名假设案例无法满足该请求:首先获取实际的过时证据,然后要求其特定关系进入课程推理。保持事件、发布和页面更新日期不同;切勿以真实机构的名义回填虚构的观察结果。
- 如果用户想要可打印纸张 HTML 或 PDF,另请阅读 references/layout-fidelity.md 和 references/rendering.md。
- 如果任何来源或生成的项目使用图形、图表、地图、表格、照片或视觉证据,请阅读 references/visual-generation.md。
- 对于 PDF 导出或水印请求,请阅读 references/pdf-provenance.md。使用不可见的元数据来源而不更改页面像素。披露其存在和限制;切勿隐藏说明或承诺不可去除的标记。来源验证与考试接受是分开的。
官方主题文件夹是:
- 学测:国文、英语、数学A、数学B、社会、自然。 国综和国写共享国文数据文件夹,但它们是独立的examinations/booklets,具有独立的计时、编号、评分和布局合同。不要将它们合并到一张 180-minute/150-point 论文中。如果两者都被要求,请制作两本单独验证的小册子。相比之下,英文版 translation/composition 保留在英文小册子内。
- 会考:国文、英语、数学、社会、自然、写作测验。将阅读和听力视为英语部分。
辅助 數學(舊制) 文件夹仅是历史文件夹。不要将 111 之前的 GSAT 数学合并到数学 A 或数学 B 中。辅助 數學(共同範圍模考) 文件夹包含当前制度的模拟考试,仅涵盖常见书籍,没有标记为 A 或 B;仅将其项目模式用于共享单元,而不是作为数学 A 或数学 B 的全文分布。当蓝图包含多个课程时,需要明确的课程,并且切勿跨制度进行抽样。
对于当前的 GSAT 论文,使用 ROC 年 111–115 作为主要形式语料库。官方 111-115 篇论文和同期出版商的模拟决定了当前的项目写作模式:主干和选项长度、刺激密度、表示变化、读写能力构建、推理深度、干扰项竞争、局部难度曲线、项目块高度、选项行排列和页面密度。 ROC 100-110 年级可以扩展课程内容和历史项目原型库,但不得设置当前的措辞、布局、读写能力或难度分布。即使较旧的文件更容易提取,此优先级也是强制性的。
当 exam_packs/學測/shared-data/historical-content-envelope.json 存在时,写作通行证只能读取它以扩大课程覆盖范围和抽象原型多样性。其禁止使用清单具有约束力。不要阅读特定于包的报告或源级别记录来获取相同的信息。
不要默默地取代邻近的科目、课程体系或考试制度。
校准门
在声明输出已校准之前运行 python scripts/exam_data.py status。仅当元数据验证且学习蓝图中 calibration_by_curriculum 为 ready 时,才会对科目和课程进行数据校准。对于 GSAT,这分别需要官方语义锚、官方目标项 P/D 曲线、完整难度向量、competence/source 注释、构造响应校准和经过验证的形式布局配置文件。
- 如果存在校准数据,则使用其观察到的单位、项目类型、分数、位置和难度的联合模式。
- 如果仅存在官方结构或目标项曲线,它可能支持分析或内容计划,但不能支持完整论文的生成声明。明确标记部分诊断。
- 如果两者都不存在,就不要发明“类似官方”的发行版。解释缺少哪些数据,或者仅在用户明确接受探索性未校准草案时才继续。
- 切勿将样本文件或单一年份视为十年趋势。
全纸结构门
要进行完整的模拟考试,请在规划各个项目之前从 metadata/papers.jsonl 中选择一个兼容的试卷配置文件。它必须指定 numbered/scored 项目总数以及每个主要部分的数量、类型组合、评分规则和顺序。使用 verified 官方配置文件进行正式的 GSAT 索赔。 auto_parsed、needs_review 或 pending_ocr 记录是证据队列,而不是正式的生成模板。
当兼容的官方和出版商模拟配置文件都通过大门时,使用 official_past_exam 进行全文结构。使用模拟考试作为解释风格和题目变化的补充证据;切勿让模拟覆盖同一政权和年份的经过验证的官方结构。
不要平均不兼容的论文结构或从松散的每个问题频率推断部分配方。如果用户明确要求忠实于特定的历史官方正府,请使用该年经过验证的个人资料。对 116 或更高版本模拟的请求默认为现有的兼容当前制度配置文件和 115 测量资产;语料库端点不是到期日期。遵循 references/official-gsat-specifications.md 中的 academic-year/regime/reference-year 策略。不需要仅仅为了更改打印的模拟年份而需要未来年份的原始或新模板,并且不要将历史证据重新标记为未来年份的证据。如果仅存在未经验证的参考架构,则停止分析或规划;永远不要声称所观察到的计数对于未来的每届官方正府都是有保证的。
正式布局大门
纸张配置文件不是布局配置文件。正式论文还必须选择 subject/regime-compatible 布局配置文件,其 fidelity_status 和指令转录均为 verified。它必须重现官方封面层次结构、完整作题答题注意事项、分数解释、部分标签、页面几何形状、运行 headers/footers、字体角色、表观字体大小、行距、页面密度行为、答题纸参考和特定于主题的答案空间。通用可读渲染器可以仅称为预览。观察到的页数是参考证据,而不是超越排版或实质性内容的目标:切勿仅仅为了强制使用相同数量的物理页而缩小字体、缩小页边距、压缩行距、放大数字、添加空白答案行或截断材料。
对于使用维护的 115 个参考模板的当前制度 GSAT 小册子,首先加载 references/gsat-115-template-assets.md 和 exam_packs/學測/templates/115/template-pack.json。使用其特定于主题的确定性模板作为封面、签名横幅、完整答案说明、评分规则、交替运行 header/footer 和(对于数学 A/B)正确的参考公式变体。 LLM 只能提供指定的动态字段:学年、考试名称、实际当前页数和实际总内页数。它不得解释、缩短、扩展或重新生成锁定的封面文本。数学 A 和 B 是单独的公式资产;数学 B 不得继承数学 A 的角度加法块。先渲染正文内容,获取真实的内页总数,然后再填充页面家具。切勿将正文强制纳入参考年份的页数,也切勿将 blank-template.pdf 视为固定页考试框架。这些资源仅用于布局,不得成为可重复使用的问题生成器、问题库或批量内容源。
在托管 Web 表面上,还加载 exam_packs/學測/templates/115/hosted-web-template-assets.json。每个持久或打包投影必须保留所有七个主题的所有 30 个不同的每个文件 download_url 记录以及每个文件的 SHA-256、字节数和页数。安装存储规则和 URLs 但不下载模板 PDF 二进制文件。在生成时,仅获取该科目的三个生产组件,或者数学的四个组件。嵌入式scripts/fetch_hosted_template_assets.py支持原始下载、GitHub内容API/base64和上传的纯数据模板资源PDF。验证组合运行时内的字节;仅在另一个工具中进行 Base64 响应并不能成功进行切换。将 scripts/compose_hosted_pdf.py 与映射的覆盖几何图形和透明的仅正文页面一起使用。保留固定的封面文本、分数、网格、规则、签名和公式正文作为原始 PDF 图层。禁止 OCR、重新输入、HTML/Word 转换、屏幕截图或锁定材料的视觉模仿。切勿下载或返回 github-pages.zip、存储库存档或全模板 ZIP。持久化 PDF 字节是可选的,不是安装门;立即在其创建聊天和以后可选择的聊天中应用本机保存的技能。如果有界网络传输失败,则根据references/hosted-pdf-production.md使用或请求单个离线资源PDF。如果仍然不具备所需的能力,请在起草前报告。除非用户首先明确接受降级,否则不要生成或提供任何通用布局替代品;给草稿贴上标签并不表示授权。在最终保存的 PDFs 上运行机械检查助手,然后实际检查每个页面和每个内容门。没有任何帮助者报告证明正式接受。
从全文评审中学到的回归门
这些检查适用于普通生成、预览、冒烟测试、定时测试和再生论文。试卷不能仅仅因为其目的是测试速度或渲染器而省略它们。
- 最终答案位置:此规则适用于所有含有单选题的全文——国综、中文、数学A、数学B、社会、自然;国写没有这样的人群,多选题不计入统计范围。审核最终打印的订单,而不是起草的订单。对于每个具有一个稳定的选项标签集且项目数至少是标签两倍的群体,从接近偶数的多重集构建位置计划,然后对其进行洗牌:当项目数可被标签数整除时,总数必须完全相等;否则最大和最小总数最多可能相差一,并且每个标签都必须出现。使用新的每篇论文洗牌而不是固定的 A-B-C-D 轮换,然后连续拒绝四个相同的答案,并将任何第 2 期到第 4 期的循环重复三次。这里的“随机”意味着平衡和模式筛选,而不是可以创建可见集群的不受约束的随机性。对于不能完全满足整篇算术的小部分,应避免漏标或过于集中,而整篇门仍然控制。多项选择答案需要单独的包含频率和集合大小审核,因此不会系统性地缺失或选择一个选项位置。切勿更改项目的真实性来填充配额:首先创作并解决该项目,排列已经有效的选项,然后重新映射并重新解决每个相关记录。
- 打印选项绑定:在任何选项移动后,更新密钥、独立的
derived_answer、精确的选项判决、解释 labels/surface 形式、词汇或干扰项记录、问题和答案哈希以及每个显示的答案表。重新渲染学生和解释 PDFs。陈旧元数据中的平衡计数是失败的。 - 正式页面配置:所选布局配置文件单独控制交替运行标题、实际 current/total 内页计数、签名条、subject/year 措辞、页脚编号、章节标题、说明框、问题编号悬挂栏、选项缩进、分数放置和答案空间形式。不要发明标题、硬编码参考论文的总页数、在学生手册中打印内部 audit/provenance 文本或添加响应行,因为仍有空间。
- 模板优先渲染:托管全文使用现有经过验证的PDFs和
scripts/compose_hosted_pdf.py,而不是模板源重建。相同的原始 PDF 规则适用于完整的本地结账。 HTML 模板模块是内部组件校样,不能替代所提供小册子中的固定 PDF 层。scripts/render_gsat_template_assets.py --build-all是维护者 asset-build/preview 命令,而不是不可用二进制文件的托管替代品。生产论文使用其选择的测量布局配置文件,并在实际分页后填充 year/test/page 字段。对锁定指令、签名措辞、公式成员资格、字段位置或类型角色的任何更改都需要新的模板版本、回归测试、重新生成的资产和全新的全页视觉审查。先前渲染的 PDF 在进行此类更改后已过时。 - 数学分数几何: 每个内联分数、填充格式分数、固定分母、评分分数和参考表分数必须是一个不间断的 semantic/geometry 单位。在最终的 PDF 大小中,验证分子正好位于一个分数条上方的中心,分母位于它下方的中心,两个级别都不会与相邻的散文冲突,并且没有分子、条、分母、符号、槽圆或答案行标签被剪裁或跨行分割。固定分母不得在其下方画第二条下划线。恰好包含正确数字的文本提取不是视觉传递。
- 响应格式完整性:如果相同角色的官方页面使用有边框的推理或完成表,则将其标题、标题、行含义、槽位和维度编码为面向学生的结构化内容,并将其绑定到内容哈希中。语义表不能被通用水平线取代,并且表不能仅仅为了占据空白而被发明。
- 实质性密度:在经过验证的字体角色、表观尺寸、行距和页边距下比较完整的印刷段落、项目块、图形和占用的页面角色。在托管模式下,
web-platform-use.md允许的公制兼容的繁体中文后备可能满足该角色,即使其内部家族名称不同。通过页数或容器高度并不能成为材料不足、间隙过大、终端页面稀疏、重复的伪表格或装饰性图形的借口。发布前修复内容和页面分配;切勿拉伸、收缩或填充。 - 难度和范围:拒绝定义查找、单线索识别、一步替换、主题名称装饰、教学大纲琐事以及只有一个远程合理的选项。每个规定的难度标签都必须有实际的最短解决方案路线的支持。社会研究和自然科学还需要 core/high-frequency 课程锚点和每个评分项目至少两个链接的证据操作,而 medium/hard 项目通常需要三个。英语难度必须来自semantic/discourse范围内的竞赛,而不是生僻词汇。国综、国写、英文、社会、自然,在起草前应用references/current-form-literacy-load.md中的构造底板;它们是数学难度设计门的非数学等价物,并根据官方 ROC 111-115 论文进行测量。
- 阅读量和共享刺激:国综、国写、中文、社会和自然都是素养论文,其项目大部分位于共享一个大量印刷刺激的题组中,包括第一部分。从独立的一两句场景组装一篇论文是一种结构性失败,而不是一种风格选择:它是短论文和简易论文缺陷的直接原因。满足
references/current-form-literacy-load.md中每个主题的组数、组刺激长度和整篇论文的实质性文本底数(根据exam_packs/學測/shared-data/current-form-literacy-envelope.json进行测量)。自然论文还必须将其六个第贰部分题组中的至少两个真正跨越物理/化学/生物/地科(CEEC在每篇官方111-115论文中声明恰好两个合科组),记录在metadata.natural_mixed_group_designs中;可以在不更改解决方案的情况下删除的第二个纪律不算数。这些是低于最弱官方年份的下限,从来不是目标,也不是填充散文、回答空间或数字的理由。 - 渲染后证据: 再次运行所有内容门,光栅化每个学生页面,并将封面、第一个内容页面、每个部分过渡、包含大 figure/table 的每个页面以及可读比例的最后两个内容页面与匹配的官方页面角色进行比较。任何渲染器更改都会使早期的视觉通道无效,直到重新生成并重新检查学生和解释 PDFs 为止。
所需的生成顺序
- 解决考试、科目、课程、year/regime、全卷或自定义练习模式、难度目标、模拟考试日期、排除项、答案配置文件和输出格式。仅当数据中存在默认值时才使用包默认值。
- 在全纸模式下,锁定经过验证的纸张配置文件和布局配置文件。将官方部分计数、顺序、分数、持续时间、说明和页面合同复制到计划中。然后在多年汇总信封内创建新的全文发行版;不要继承以前生成的论文或复制历史年份的单元序列。视觉项目必须包含视觉规格;
requires_diagram: true无一无效。源分析必须以抽象工件结束;项目作者不得接收源词干、数字元组、源顺序方程、源问题 ID 或源图拓扑。 对于当前的 GSAT 一代,每个项目规范必须引用由多个兼容管理构建的 111-115 聚合形式模式集群。 111 之前的记录可能仅影响总体课程覆盖范围和历史原型多样性;它从来都不是物品种子。 对于 20 题的数学 B 试卷,在选择表面上下文之前,通过references/current-gsat-math-scope.md中的五股蓝图和窄族上限分配插槽。切勿将无约束模型采样称为平衡分布。维持滚动的三式数学 B 旋转分类帐:单点透视和 latitude/longitude 或球坐标转换必须在每三个连续的形式中至少出现一次,而每个单一形式仍然保留广泛的覆盖范围,而不是机械地重复这两个主题。 - 为每个兼容的目标槽附加官方难度目标,并为每个构建的响应槽附加单独的 official/pilot 量规校准。保留部分重置、位置曲线、年度例外以及目标和实现的 P 之间的区别。对于当前数学,在撰写散文之前向每个评分项目添加
difficulty_design记录。它必须命名不可简化的链接决策、表示变化或约束检查、误解路径、歧视移动以及捷径崩溃审计的结果。计算代数线数或命名几个教学大纲概念并不是困难的证据。 当早期生成的论文存在定时审稿人反馈时,请将其保存为单独的反馈校准记录。用它来调整下一篇论文的实际推理架构,而不是其官方目标标签。完整的数学论文必须包含满足references/math-difficulty-design.md中计数深度门的非常规D-10-3项;直接阶乘乘法或单个对称性减半步骤不能是本文唯一的组合数学覆盖范围。 - 为模拟编辑锁定之前可用的来源中的能力项目建立一个过时的灵感库。匹配源系列和交付周期分布;永远不要仅仅因为当前事件感觉热门而使用它。使用
scripts/validate_inspiration_pool.py验证池。单独记录语料库覆盖范围:被散列、索引或视觉扫描的文件并不意味着它的问题被语义读取。当 OCR 或项目注释不完整时,请披露确切的差距,并且不要声称模型已经学习了每个提供的问题。 对于《国综》和《自然》,在起草之前根据完整提供的 official/mock 语料库筛选每个提议的源标题、作者-作品对、独特引用短语、数据集名称和规范 URL。运行scripts/audit_source_novelty.py source-registry.json output-report.json。零词汇命中只是一个分类过程:还检查别名、翻译、备用标题、摘录边界以及是否通过另一种表示形式出现相同的源对象。将结果存储在源注册表中;不要将源论文的措辞暴露在写作过程中。 - 写出满足每个项目规格的原始问题。测试预期的概念,而不是表面的数字变化。在起草表面上下文之前需要新的信息机制、解决方案图和表示语义。为每个评分项目生成至少三个相互不同的候选机制;不要将课程单元绑定到用户示例或重复域。从新的语义数据中呈现答案图表;仅将图像生成用于非精确的视觉上下文并遵循视觉生成参考。
Original描述的是评估设计,而不是阅读材料的作者。请勿发明段落、诗歌、日记、档案记录、访谈、公告、研究结果或所谓的真实数据集,然后将其打印为源材料。选择已通过语料库新颖性筛选的可追踪发布源;仅在权利允许的情况下引用,否则通过审核图进行准确的归因改编,返回源命题。请勿在学生试卷中打印自擬、本卷自擬或數值為自擬等标签。如果某项任务确实需要模拟数据,则只有在用户明确允许并且论文被标记为自定义练习而不是基于源的完整模拟时才可以使用它。 对于以能力为导向的项目,刺激必须是证据而不是装饰。应用references/stimulus-generation.md的刺激去除测试;如果在消除刺激后该项目仍然可以用相同的推理来回答,请重写它或将其标记为基本项目。 还要应用源关系测试:允许匿名名称,但删除源派生关系、表示、约束或决策必须改变推理。一个主题名称本身就是装饰性的。参见references/evidence-backed-editorial-audit.md;当前的材料必须提供数学或修辞的可供性,而不是声望词汇。 应用有限的新颖性:只有当项目中定义了每个外部规则,不需要外部领域知识,并且完整的解决方案简化为所选课程中的命名概念时,才允许使用不熟悉的专业、技术、日常生活或大学相关机制。新颖的背景不得使难度超出相关内容目标。 不要对主题与单元的关联进行硬编码。航天、语言模型、望远镜、公共自行车、能源系统或任何用户示例都只是候选。对于每个槽,比较至少三个相互不同的信息机制,包括非主题替代方案,并根据证据必要性、课程适合性、解决方案质量和目标难度进行选择。 无一例外地将原创性防火墙应用于每个评分项目:纯文本、单选、多项选择、填写、构建响应以及每个混合组子部分。对于填充,只能重复使用官方标记栏。对于混合组,共享对象和子部分之间的依赖关系也必须重新发明。 照片必须带有可审核的出处记录:原始的、公共领域的、许可的、用户提供的或在网络上找到且来源可追溯的(web_sourced;不需要许可裁决,维护者决定 2026-09-24)。当它以灰度打印时,在项目检查之前冻结确切的裁剪和色调转换。每个带有答案的特征在没有色调的情况下在最终打印尺寸下都必须保持可区分性。除非通过标签、图案、形状、位置或打印值对相同的区别进行冗余编码,否则与颜色相关的提示将被拒绝。切勿要求学生从灰度复制品中识别颜色。 在解决之前,请根据所选的当前官方手册进行实质性表面审核。比较独特的刺激体积、完整的项目块体积、source/representation 组合以及实际占用的页面面积的数量。仅当匹配的当前形式角色也很短时才允许短独立场景;一篇完整的论文可能不是由一两句话的小场景加上通用选项组成的。课程代码、声明的两步操作或填充的元数据字段不能弥补印刷材料中缺失的证据。 - 在单独的推理过程中解决每个问题。对于高风险的数学、科学、模棱两可的阅读或构建的响应,请在可行的情况下使用独立的第二条路线或确定性计算。可打印的答案材料必须保留每个项目的实际计算、证据比较、模型边界或评分点。诸如“符合问题说明数据与模型”、“排除超出数据支持范围的叙述”之类的样板,或跨项目重复的相同通用两行基本原理不是解决方案,并且会阻碍发布。对于选定的反应,说明决定性的证据和至少主要的干扰因素区别;对于构建的响应,显示实际用于奖励积分的计算或可审核的标题元素。
- 验证范围两次:首先将每个数学运算映射到一个或多个官方学习内容代码,然后审核实际措辞和解决方案路径,以查找隐藏的超出范围的术语、定理或过程。运行
scripts/validate_math_curriculum.py进行数学 A/B 并要求对每个defined-bridge项目进行人工审核。然后验证可回答性、适用的唯一答案、干扰项、单位、图表、答案分布、重复概念、总分、难度向量匹配、刺激必要性和蓝图拟合。答案分配审核根据最终打印选项顺序运行:拒绝明显遗漏的标签、两个标签集中、机械模式或无法解释的长期运行。重新排序选项需要重新映射密钥、独立解决方案、每个选项判决和解释标签,然后是新的 content/answer 哈希值和完整的重新渲染。接近偶数的计数是编辑默认值,不允许更改哪个陈述是正确的。针对官方、模拟和已生成的项目运行词汇分类以及来自references/originality-firewall.md的强制结构皮肤交换审核。还验证来自references/llm-original-item-generation.md的论文级多样性矩阵。仅更换失败的项目并重新检查整张纸。任何继承旧版生成的问题内容的构建都会被完全拒绝。 对于国综和自然,根据 CEEC 级别的控制 CEEC 考试规范验证每个项目。自然科学论文必须在物理、化学、生物学、地球科学和 inquiry/practice 两个主要部分之间取得明显的平衡;在元数据中命名学科并不是范围审计。运行scripts/validate_chinese_natural_scope.py generated-exam.json --report output/scope-report.json,然后使用冻结的源注册表运行scripts/validate_source_grounding.py,并在渲染之前传递新颖性报告。编造、拼写错误或主题错误的课程代码会阻碍发布,即使散文似乎切中主题。 对于带有源的项目,验证打印的事实与冻结的源快照一致,发明的值明确标记为简化或模拟,URLs 和日期保留在审计注册表中而不是弄乱正式的文件,并且删除源派生关系会更改解决方案。对于国写,请验证每个提供的段落都有独特的修辞工作,每个材料段落都有material_source_map,每个印刷案例都来自已识别的来源,并且没有来源记录发明了建模值。第二个任务必须包括作者撰写的中文文学来源,或可追溯的已发表的中文翻译,适合情感表达,而不是默认机构解释者或新发现的英语网络文章。在学生页面上,来源归属位于材料段落末尾的全角括号中;它不是一个单独的源块。不要将所提供的段落命名为材料一:或材料二:;仅当多个文本需要标签时才使用官方风格的甲/乙标记。运行scripts/validate_writing_source_grounding.py并将任何失败视为释放阻塞。 对于国综、国写、中文、社会和自然,请在 布局之前 编写的考试上运行scripts/validate_literacy_load.py generated-exam.json --subject <科目> --report output/literacy-load.json。它拒绝印刷的论文实质上少于官方小册子,共享刺激题组太少,小组刺激太短,或者其自然混合小组永远不会离开一个学科。通过恢复真实的源材料和完整的项目块来修复故障;切勿通过扩大字体、夸大数字、扩大答案空间或添加填充物的方式。结构通行证不是编辑通行证。 对于数学,运行scripts/validate_math_difficulty_design.py并拒绝任何计划难度崩溃为直接替换、一个熟悉的公式、一个常规线性系统求解或重复执行相同操作的项目。在有代表性的试点数据存在之前,仅将模型估计的歧视视为设计标签。然后验证每个项目的显式option_layout(row-5、row-4、grid-3-2、grid-2或stack)。数学 111-115 打印选项并排五个或每行一个;渲染器打印数学 A/B 选项,每行超出所选选项卡一个,而不是将它们包装在单元格内,因此选择stack作为句子长度选项。切勿仅根据字符数推断打印的排列。根据最近的参考页面验证渲染的选项基线和选项间空白。 每个数学填写项目必须声明机器标记的answer_format: integer/decimal/fraction/sign 形式、精确的分子和分母槽数以及小册子中打印的连续答案行 ID。渲染器必须显示学生将标记的相同 circle/rail/fraction 几何体;通用的空行是一个硬故障。 当前的数学论文还必须满足其在多个部分中所学的答案承载视觉配额。在项目级别 111-115 视觉注释完成之前,内部审查层是至少三个部分的四个所需的视觉效果或结构化图形表示,其中包括混合响应部分之前的至少一个项目。装饰图片不算在内。 同样的稳定性要求适用于当前的数学 B、自然科学、社会研究和英语论文;它不是数学 A 独有的功能。直到每个 subject/year 都有完整的项目级注释,使用这些保守的内部发布层:数学 A/B4 visuals / 3 sections / 2 kinds;自然科学16 / 2 / 4,涵盖物理、化学、生物和地球科学,包括至少一张可追溯的真实照片或观察图像(每年官方111-115印刷16-28张标记图,几乎所有绘制的图表、仪器和表格,以及0-2张照片),每个图和表格标题为“图N/表N”并在其词干中引用;社会研究10 / 2 / 4,涵盖历史、地理和公民,包括至少2张可追溯的真实照片或档案图像和18个引用图/表/照片的项目(官方111-115:每年2-4张照片或档案图像和7-13张图表、地图和表格,18-45个引用数字的项目);英文3 / 2 / 2,包括至少一张可追溯的真实照片以及非连续的混合材料或选定的构图形式。照片数量仅是下限:自然科学和社会研究没有照片数量上限。不要仅仅因为验证者楼层已过而在两点停止;保留每一张额外的来源照片,这些照片引入了独特的、带有答案的观察结果,并改善了部分、来源系列或学科传播,而不损害权利安全、灰度生存、页面密度或解决时间。同样,切勿仅仅为了增加数量而添加装饰性图像。生成的照片写实主义、屏幕截图、装饰图片以及其决定性证据在灰度中消失的照片不能满足这些真实图像的要求。这些是产品底线,未声明 CEEC 频率。选定的带注释的配置文件可能会提高最小值,而不会默默地降低它或强加任意最大值。 与官方手册一样,用中文标注每个图形和表格(样品、硫酸根、发酵液、反应进程、时间);仅保留拉丁字母的符号、单位、公式和首字母缩略词(x、t (s)、mol、NaCl、DNA、NOAA)。validate_visual_item_contract.py拒绝semantic_data标签、SVG 文本和 PDF 图形中的英文单词;它无法读取光栅,因此在查看页面时请检查 PNG 的标签。 每个计数的视觉效果都必须是解决方案的证据或必需的,设置item_spec.requires_diagram: true,包括完整的架构visual_asset.visual_spec,枚举包含答案的功能,并通过视觉删除测试。运行scripts/validate_visual_item_contract.py generated-exam.json。如果一篇完整的论文错过了它的主题信封,用新设计的视觉项目替换失败的或纯文本的项目并重新解决它;切勿附加装饰性图像来保留旧茎或放大图形以填充页面。 声明的视觉类型必须匹配渲染的科学拓扑,而不仅仅是其元数据标签。坐标图需要坐标轴、比例尺和标绘标记;轮廓或横截面需要空间 layers/paths;光谱需要波长轴和谱线;设备或电路需要连接组件;流程图需要有意义的节点和有向链接。重述提示值的单栏框不是图表、地图、剖面图、频谱、仪器、流程图或证据矩阵。不要通过一个通用的标签和行面板路由异构视觉类型。真正的数据表必须具有解决方案使用的显式 row/column 比较结构;已打印事实的垂直列表不是数据表。如果删除该数字会在散文中留下答案所需的所有数字和关系,请删除多余的数字或重写该项目,以便该数字实际上带有证据。发布前,记录representation_audit,包括拓扑族、渲染图元类型、语义通道、提示冗余结果、视觉去除结果;拒绝伪装成表示多样性的重复的几乎相同的面板拓扑。 来源照片必须将下载的原始照片保留在放置的衍生作品旁边,并对两个文件进行哈希绑定。记录稳定的源页面、创建者或机构、指定的许可证、原始文件路径和散列、固定裁剪、处理步骤、目标打印宽度和有效光栅分辨率。分页前将放置的资源转换为固定灰度或双层文件;不依赖打印机转换。最终尺寸审核必须在单色页面中找到每个包含答案的边界、对象、数量、纹理、标签或相对色调,而无需查阅彩色原件。 完整的社会研究论文必须在项目数量和分数上保持历史、地理和公民学的真正平衡,完整的自然科学论文必须在物理、化学、生物学和地球科学方面做到同样的事情。在带注释的所选年份配置文件提供更严格的值之前,内部失败关闭限制是最大到最小的项目计数差距最多为3,分数份额差距最多为8个百分点。validate_social_item_design.py和validate_chinese_natural_scope.py强制实施这些限制;仅仅为每个学科命名一次是不平衡的。 对于英语,运行scripts/validate_english_vocabulary_scope.py generated-exam.json <CEEC-reference-vocabulary.pdf> --report output/english-vocabulary-scope.json、scripts/validate_english_difficulty_design.py generated-exam.json和scripts/validate_english_layout_contract.py generated-exam.json。处理超出信封的非阅读单词、高于 5 级的词汇目标、option/answer/explanation 之间缺少精确的表面形式绑定、大多数词汇项的合理干扰项少于两个、狭窄的干扰项家庭混合、超过一个简单的词汇锚、少于五个 medium-hard/hard 词汇项、通过硬标签伪装的单提示或仅后缀的快捷方式、非中文作文方向、不连贯的强制书写提示、或由于发布阻塞而导致的部分显示合同失败。使用近义词、搭配、一词多义、论证结构、语域、语义韵律、话语关系,并在整个部分控制 word-form/word-family 竞争;仅当基于形式的干扰项在语法上仍然合理并且被完整句子的证据击败时,它才算数。正宗阅读材料中的 6 级或列表外单词需要本地支持或记录的只读例外情况;稀有性可能并不是困难的根源。 对于社会研究,运行scripts/validate_social_item_design.py generated-exam.json --report output/social-item-design.json。curriculum_codes必须包含references/social-required-content-codes.json中 10-11 年级所需的学习内容代码;将学习绩效代码保留在单独的字段中,并将 CEECH/G/C/S评估目标保留在ceec_assessment_targets中。将伪装成内容的性能代码、elective/invented/wrong-domain 代码、缺失的课程对齐记录、不受支持的当前事件声明、装饰性专有名词、非独立领域规则、无证据能力标签、裸定义回忆或低优先级课程目标视为发布阻止。每个评分项目(包括基本锚点)必须记录核心或高频课程锚点,禁止仅回忆解决方案路径,并且需要至少两个基于证据、关系、原因、约束、规模或程序的链接操作。与跨学科团体一起保留可识别的历史、地理和公民报道,而不是使整篇论文成为热门新闻段落的集合。 对于当前完整的社会研究论文,满足references/current-gsat-social-form.md的一年内楼层(10 项,180 天内 4 项,5 种材料,每个部分 4 种)及其三主题题组楼层(第一部分中至少有一项,第贰部分中至少有两项,其项目依次以历史、地理和公民为主导);仅用作装饰的活动名称、日期或时尚技术不算在内。也运行scripts/validate_social_layout_contract.py:它强制执行在111-115上测量的打印形式(等长选项,关键是最多四个项目中最长的选项,「26-27为题组」,「(3分,35字内)」,两个部分标题,没有打印的创作注释或空白答案框)。 对于每张带有答案的照片或光栅图,在其视觉规范中要求grayscale_evidence_survival和color_independence并以打印比例检查最终的光栅化页面。模式合规性本身并不是视觉通行证。新颖性意味着新的信息机制、解决方案图、语义数据和视觉拓扑——不是不寻常的主题、灰度过滤器、裁剪、旋转、重新标记或艺术重新设计。精确的图表、轴、边界、比例、标签、状态区域、地图和测量值必须是确定性的;图像模型可能仅在确定性答案承载覆盖层下提供不精确的上下文。 将照片权利和信用保留在内部来源分类账中。请勿打印学生手册中可选的照片源行,除非所选的官方布局配置文件明确包含这些行;文本 material/source 行仍然受其自己的官方形式规则的约束。如果许可证要求可见的归属与形式不兼容,请更换来源或获得适当的许可;内部元数据永远不会取代所需的可见信用。 - 将学生论文和答案材料分开。产生结构化
exam.json;对于固定页校样,在 PDF 导出之前渲染 HTML 并传递scripts/validate_fixed_page_html.py。门必须覆盖水平和垂直溢出以及包含边框的说明框、表格、响应示例和可打印页框。然后对 PDF 进行光栅化,并在正式索赔之前以可读比例检查每一页。页数、提取文本密度、字体清单或联系表本身无法确定没有任何内容被剪裁。最小高度框不是打印内容:将实际 text/figure 结尾和分布式工作空间与所选参考进行比较。通过实际的 raised/lowered 位置验证函数的幂和对数基数,而不仅仅是较小的数字或看起来有效的标签。共享渲染器更改后,重新生成受影响的 PDFs 并撤回过时的视觉通道,直到审核新页面。对于当前的数学 A/B 混合答案项目,请勿在问题手册中打印工作簿样式的答案行,除非控制官方布局配置文件明确包含它们。 对于国综和自然,还可以通过运行scripts/validate_current_form_density.py将每个渲染的内容页面与 ROC 111–115 密度包络进行比较。在这个项目中,页面密度是一个固定规则(scripts/hosted_density.py,由计划、检查员和最终检查共享):正文页最多留出可打印正文的 32% 空白(中文 42%),最后一个正文页最多留出 60%,并且不会放弃超出限制的页面。候选人的完整论文可提取文本量还必须达到控制官方论文的至少 80%(或没有年份控制时的最近官方总数的最低值)。这是一个反填充地板,不是复制的目标或权限。 CSS 最小高度、扩大间距、空白答案规则、装饰标签和图形边界框不算作实质性材料。请勿通过缩小页数、放大字体或添加装饰性填充物来修复填充不足的页面;重新平衡实质性源摘录、项目块、参考支持的答案空间、精确数字和页面转换,同时保持可读性。请勿自动附加來源補充、添加揭示答案的评论、夸大数字或过度分配响应行以通过此指标。在references/current-gsat-chinese-natural-form.md中应用特定于角色的排版和 SVG text/stroke 检查;当更正的证明暴露出实质性长度不足时,保留失败的完整形式状态。总页数与半空页的匹配不是布局保真度。 对于每个当前形式的主题,导出后运行适用的 PDF 密度比较:validate_reference_page_density.py对于选定的官方小册子和validate_current_form_density.py对于维护的国综/自然多年信封。比较匹配的页面角色,并要求至少 80% 的官方参考文献的实质性文本量,除非经过审阅的带有答案的视觉效果取代了散文。如果页面通过了溢出检查,但结束时间明显早于其官方对应页面,或者容器到达底部但文本量很短的纸张,仍然是发布失败。通过恢复真实的源段落、必要的上下文、完整的项目块、不连续的证据或自然的页面流来修复它。页数差异本身并不意味着发布失败;记录它并查看生成的页面角色。对于国写,明确地将每个印刷源包的散文长度和修辞功能与相应的官方任务进行比较;简短的提示加上超大的响应区域并不是完整的写作任务。切勿创建一个大的终端空白,也切勿通过缩小或膨胀字体、更改经过验证的 margins/line 间距、扩大答案空间或数字或添加不相关的散文来掩饰空白。只有在满足实质性内容长度合同后,完整项目之间的小分布间距才是可接受的。
输出必须说明它使用的包、主题、curriculum/regime、蓝图指纹和校准级别。
原创性和私人数据
歷屆試題/和模擬考/中的历史文件是持久的校准数据。
由于大小和原因,它们可能会从普通的 Git 树或技能档案中省略。
分发原因,但必须保持可通过检查的源包恢复
清单和引导工作流程。切勿仅仅因为删除、移动或替换它们
它们被忽略、不存在于公共克隆中或被打包程序排除。一次清理
针对生成输出的请求不包括源文件、源注册表、
原始摄入量、模板或校准证据。那些破坏性的改变
确切的资源需要明确的请求来命名它们。
- 学习抽象概念:单位、概念、技能、刺激类别、项目类型、难度向量、分数、位置、视觉功能和常见误解。将这些抽象保留在与源措辞和图形拓扑不同的单独工件中。
- 请勿复制、轻微转述、翻译或仅仅交换源项目中的数字。
- 除非用户确认必要的权利,否则请勿发布源段落、图像、答案或完整的历史问题。
- 如果相似性不确定,则更改信息机制、解图、表示语义和表面上下文,然后再次验证。仅靠表面变化并不能解决结构匹配问题。
存储库工具
当本地执行可用时使用存储库助手(有些需要 PDF/browser 依赖项):
python scripts/audit_exam_pack.py --output output/pack-audit.json
python scripts/validate_exam_release.py exam.json --contract run-contract.json --stage content --output output/content-gate.json
python scripts/validate_exam_release.py exam.json --contract run-contract.json --stage delivery --output output/delivery-gate.json
python scripts/audit_generated_suite.py form1.json form2.json --output output/suite-audit.json
python scripts/exam_data.py index-sources
python scripts/build_paper_profiles.py
python scripts/analyze_pdf_visuals.py
python scripts/build_visual_queue.py
python scripts/build_question_candidates.py --promote
python scripts/download_ceec_gsat_statistics.py --min-roc-year 100
python scripts/import_ceec_gsat_difficulty.py
python scripts/build_gsat_difficulty_profiles.py
python scripts/analyze_gsat_official_patterns.py
python scripts/analyze_mock_exam_dataset.py --intake <本次資料夾>
python scripts/analyze_mock_bundle.py --bundle "<正式套卷名稱>"
python scripts/analyze_historical_content.py
python scripts/build_layout_review_queue.py
python scripts/analyze_stimulus_ecology.py --exam 學測 --subject 社會 --output output/social-stimulus-ecology.json
python scripts/analyze_writing_source_corpus.py <資料夾...> --output output/writing-source-corpus.json
python scripts/validate_inspiration_pool.py output/current-inspiration-pool.json
python scripts/audit_item_originality.py generated-exam.json output/originality-audit.json
python scripts/validate_llm_originality_contract.py generated-exam.json
python scripts/validate_math_curriculum.py generated-exam.json
python scripts/validate_math_difficulty_design.py generated-exam.json
python scripts/validate_english_vocabulary_scope.py generated-exam.json <CEEC-reference-vocabulary.pdf> --report output/english-vocabulary-scope.json
python scripts/validate_social_item_design.py generated-exam.json --report output/social-item-design.json
python scripts/validate_chinese_natural_scope.py generated-exam.json --report output/chinese-natural-scope.json
python scripts/validate_source_grounding.py generated-exam.json source-registry.json --novelty-report source-novelty.json --report output/source-grounding.json
python scripts/validate_current_form_density.py generated-student.pdf --subject 國綜 --report output/form-density.json
python scripts/exam_data.py validate
python scripts/exam_data.py build-blueprints
python scripts/exam_data.py plan --exam 學測 --subject 數學A --count 10
python scripts/exam_data.py plan --exam 學測 --subject 數學A --full-paper --paper-year 2025
python scripts/render_visual.py templates/visual-spec.json output/example-graph.svg
python scripts/render_exam.py examples/synthetic-exam.json output/exam.html
python scripts/render_pdf.py examples/synthetic-exam.json output/exam.pdf
python scripts/validate_fixed_page_html.py output/paper.html
render_pdf.py 使用本地安装的 Chrome、Chromium 或 Edge 并保留 CSS A4 页面大小。如果没有受支持的浏览器或本地执行可用,请提供可打印的 HTML 或手动遵循架构。当验证器没有运行时,切勿声称它已运行。
每个评分项目使用 templates/llm-originality-record.json,纸质和混合组记录使用 templates/paper-originality-matrix.json。这些只是审核表格;它们的占位符值并不是通过的证据。
-
10.02
MySQL 自定义函数应用场景全解析实用指南
-
10.02
rule-audit:AI Agent 工具实践指南
-
10.02
taiwan-exam:AI Agent 工具实践指南
-
10.02
logic-lens:AI Agent 工具实践指南
-
10.02
mvp-guardian:AI Agent 工具实践指南
-
10.02
unchore-defend:实践指南
-
专题
三国战纪-风云再起 整合版
-
专题
三国战纪-乱世枭雄
-
- marblo:AI Agent 工具实践指南
- 10.02
-
-
-
- clueless:AI Agent 工具实践指南
- 10.02
-
-
下载
- |
-
-
下载
- 《行尸走肉第一章》免安装中文汉化硬盘版下载
- 单机|436 MB
- 一款以动作冒险为主题的游戏
-
-
下载
- 《街头霸王X铁拳》免安装中文汉化硬盘版下载
- 单机|111MB
- 一款非常好玩的格斗游戏
-
-
下载
- |
-
-
下载
- 《暗黑破坏神3》免安装繁体中文正式版下载
- 单机|7630 MB
- 一款以角色扮演为主题的游戏
-
-
下载
- 《马克思佩恩3》免安装硬盘版下载
- 单机|27033 MB
- 一款以第三人称射击为主题的游戏