LangChain JS 首 Token 记早了?按回答文本和前端消费分别计时
聊天页面尚无正文,首Token指标却已写入,应分别记录首块与目标回答的首段非空白文本。要覆盖用户等待,再从前端提交前起表,记录收到文本和实际DOM写入;回调、流块和模型Token不能当成相同单位。
1. 同一个聊天任务,先选你要测的边界
假设用户提交问题,服务端先检索、调用模型,再通过网关把回答流送回页面。一次模型调用前开启的计时不包含之前的检索;后端收到文本,也不等于浏览器已收到或渲染。下面的完整实验使用 Node.js 22.23.4、@langchain/core 1.3.4、@langchain/openai 1.8.0,前端验证使用 Chrome 156.0.8078.80。
| 指标 | 本例起止边界 | 不能代表什么 |
|---|---|---|
| firstChunkMs | model.stream调用前→首个AI消息块 | 不保证已有回答文本 |
| firstAnswerTextMs | 相同起点→首段非空白回答文本 | 不是提供商内部首Token,也不是前端绘制 |
| firstClientTextMs | 前端提交前→浏览器消费到首段非空白文本 | 不保证框架已提交DOM |
| firstDomWriteMs | 相同前端起点→同步追加首段文本后 | 不保证屏幕像素已经绘制 |
| totalMs+status | 模型调用前→流结束或异常退出 | 不能代替缺失的首段文本时间 |
阶段时长分别用同一进程的 performance.now 计算,再通过请求标识关联前后端。不要直接相减两个进程的单调时间戳;涉及多次调用或重试时,整轮请求和每个调用应各有记录。
2. 用本地模拟流复现:空块先来,正文后到
以下是计时逻辑实验,不调用线上模型,也不测模型推理速度。安装 @langchain/[email protected] 与 @langchain/[email protected],保存下面三个文件后执行 node run.mjs。第一个文件 mock-server.mjs 提供本地 Chat Completions 兼容 SSE:约定先等20ms发角色空块,再等20ms发空白,再等80ms发“你好”;定时器与框架开销会影响实测值,不能将设定延时当精确性能承诺。
import { createServer } from 'node:http';
import { setTimeout as delay } from 'node:timers/promises';
export async function startMockServer() {
  const server = createServer(async (req, res) => {
    if (req.url !== '/v1/ch@t/completions') {res.writeHead(404).end(); return;}
    let body = ''; for await (const part of req) body += part;
    const scenario = JSON.parse(body).messages.at(-1).content;
    res.writeHead(200, {'Content-Type':'text/event-stream', 'Cache-Control':'no-cache'});
    const send = (delta, finish = null) => {
      if (!res.destroyed) res.write('data: ' + JSON.stringify({id:'ch@tcmpl-local',
        object:'[email protected]',created:0,model:'mock-ch@t',
        choices:[{index:0,delta,finish_reason:finish}]}) + 'nn');
    };
    await delay(20); send({role:'assistant',content:''});
    await delay(20);
    if (scenario === 'error') {
      res.write('data: '+JSON.stringify({error:{message:'simulated failure',type:'server_error',code:'mock_error'}})+'nn');
      res.end(); return;
    }
    if (scenario === 'tool') {
      send({tool_calls:[{index:0,id:'call_local',type:'function',
        function:{name:'lookup',arguments:'{}'}}]},'tool_calls');
    } else {
      send({content:' n'});
      await delay(80); send({content:'你好'});
      await delay(20); send({content:'。'});
      send({},'stop');
    }
    res.write('data: '+JSON.stringify({id:'ch@tcmpl-local',object:'[email protected]',
      created:0,model:'mock-ch@t',choices:[],usage:{prompt_tokens:1,completion_tokens:1,total_tokens:2}})+'nn');
    res.end('data: [DONE]nn');
  });
  await new Promise(resolve => server.listen(0,'127.0.0.1',resolve));
  return {baseURL:`http://127.0.0.1:${server.address().port}/v1`,
    close:() => new Promise(resolve => server.close(resolve))};
}
这里同时准备仅工具调用和错误场景,最终用量块没有正文,用量数值也是模拟占位,不用于真实Token统计。模拟模型名与密钥都只用于本地服务器,真实 LangChain ChatOpenAI 适配器负责解析这些流;实验没有证明任一线上提供商总会按相同顺序发送事件。
3. 按实际文本计时,并保留无文本结果
第二个文件 measure.mjs 将计时放在 await model.stream 之前,避免只统计迭代循环。字符串内容直接读取;块数组只提取本例约定的 type:text,忽略工具、推理与元数据块。trim 仅用于判断首段非空白文本,不会裁剪累积或传给前端的实际内容。
// 本例只认字符串内容和 type:'text' 的文本块。
export function answerText(content) {
  if (typeof content === 'string') return content;
  if (!Array.isArray(content)) return '';
  return content.filter(b => b?.type === 'text' && typeof b.text === 'string')
    .map(b => b.text).join('');
}
export async function measure(model, input, {signal, onText = () => {}} = {}) {
  const started = performance.now();
  const stats = {firstCallbackMs:null, firstCallbackWasBlank:null,
    firstChunkMs:null, firstAnswerTextMs:null, totalMs:null,
    status:'running', chunks:0, text:''};
  try {
    const stream = await model.stream(input, {signal, callbacks:[{
      handleLLMNewToken(token) {
        if (stats.firstCallbackMs === null) {
          stats.firstCallbackMs = performance.now() - started;
          stats.firstCallbackWasBlank = token.trim().length === 0;
        }
      }
    }]});
    for await (const chunk of stream) {
      stats.firstChunkMs ??= performance.now() - started;
      stats.chunks++;
      const text = answerText(chunk.content);
      // 不裁剪实际输出;这里只用 trim 判定首段非空白回答文本。
      if (text.trim().length > 0) stats.firstAnswerTextMs ??= performance.now() - started;
      stats.text += text;
      if (text !== '') onText(text);
    }
    stats.status = signal?.aborted ? 'aborted' :
      stats.firstAnswerTextMs === null ? 'completed_without_answer_text' : 'completed';
  } catch (error) {
    stats.status = signal?.aborted ? 'aborted' : 'error';
    stats.errorName = error.name;
  } finally {
    stats.totalMs = performance.now() - started;
  }
  return stats;
}
firstCallbackMs 是特意保留的对照。本次适配器确实对空字符串调用了 handleLLMNewToken,所以第一回调已经发生时,回答仍为空;不应仅依据回调名称推断用户收到了文字。适配器、模型模式和版本都可能改变事件内容,其他内容块格式需要按实际约定适配,不能对任意对象做 String(...) 后就当回答。
无文本正常结束保留 completed_without_answer_text;错误、取消各有状态,尚无文本的时间保持 null。若已经出现文本后出错,已有首段文本时间仍保留,同时状态为 error。这里的错误还可能来自消费回调,所以调用方必须检查 status,不能把返回统计对象本身当成调用成功。
4. 跑同一组输入,对照首块、首文与退出状态
第三个文件 run.mjs 设置 maxRetries:0,避免本地演示混入自动重试;useResponsesApi:false 明确测试 Chat Completions 路径。取消案例在60ms发出中止信号,另测了请求开始前即取消的情况。生产超时、重试和代理缓冲应单独纳入请求级口径,不能直接照抄演示的时间参数。
import { ChatOpenAI } from '@langchain/openai';
import { startMockServer } from './mock-server.mjs';
import { measure } from './measure.mjs';
const mock = await startMockServer();
try {
  const model = new ChatOpenAI({model:'mock-ch@t',apiKey:'local-test-key',
    useResponsesApi:false, maxRetries:0, streamUsage:true,
    configuration:{baseURL:mock.baseURL}});
  for (const input of ['normal','tool','error']) {
    console.log(input, JSON.stringify(await measure(model,input)));
  }
  const controller = new AbortController();
  const timer = setTimeout(() => controller.abort(),60);
  console.log('abort', JSON.stringify(await measure(model,'normal',{signal:controller.signal})));
  clearTimeout(timer);
} finally { await mock.close(); }| 本次模拟输入 | 首块ms | 首段非空白文本ms | 实际退出状态 |
|---|---|---|---|
| normal | 37.85 | 140.12 | completed |
| tool | 27.03 | null | completed_without_answer_text |
| error | 24.10 | null | error |
| abort | 24.30 | null | aborted |
normal 的首回调约37.97ms,且 firstCallbackWasBlank 为 true;首段文本约140.12ms,累计输出保留前导空白,最后为“你好。”。这些是单次本地实际采样,不是吞吐基准或线上等待承诺。仅工具流可能是 Agent 的中间步骤,不一定是整轮业务失败;表中的 null 也不能替换成0或总耗时混入普通首文分位数,应连同结果状态单独统计。
5. 用户等待要在前端另记,DOM写入也不是绘制完成
若现有前端已经拿到文本增量,可在提交时、发请求前创建下面的 client-metrics.mjs 接收器,每次把同一条回答的文本传给 push。本例使用原生 DOM 同步追加,才能在 append 后记 DOM 写入;React 的 setState 或其他异步渲染调用不能直接当成提交完成时刻。
export function createTextSink(element) {
  // 在用户提交时、发起请求前创建;所有差值都使用本浏览器时钟。
  const started = performance.now();
  const stats = {firstClientTextMs:null, firstDomWriteMs:null};
  return {
    stats,
    push(text) {
      const first = stats.firstClientTextMs === null && text.trim().length > 0;
      if (first) stats.firstClientTextMs = performance.now() - started;
      element.append(document.createTextNode(text)); // 本例原生DOM同步追加
      if (first) stats.firstDomWriteMs = performance.now() - started;
    }
  };
}
本次另用真实 Chrome 页面通过本地服务消费同一模拟流,收到首段非空白文本与同步 DOM 写入都记录约139.40ms,最终页面确实显示“你好。”。两值相同只代表本次时钟精度下没有区分出间隔,不证明绘制零耗时;它们和上一表是不同请求、不同计时起点,不能相减来估算网络开销。
如果 UI 会缓冲 Markdown、隐藏某些内容或合并更新,应把展示判断与该 UI 策略对齐,并在实际提交阶段补点。空白过滤只定义本例的“首段非空白文本”,不能判断零宽字符、字体、样式和像素可见性;requestAnimationFrame 发生在绘制前,也不能单独证明用户已看到字。
6. 多节点或多模式流,先找最终回答来自哪里
以上代码只针对直接 ChatModel.stream 的 AIMessageChunk。Agent 或 LangGraph 的 messages、updates、事件投影可能返回不同结构;有些模式包含消息与元数据的元组。应先按实际接口解包,并按节点、模型运行或消息身份选中要展示的回答,再提取文本,避免把检索进度、工具参数、推理内容或其他并发请求混进同一计时。版本升级后重新核对接口形态,不能把直接模型循环当成所有 Agent 流的通用写法。
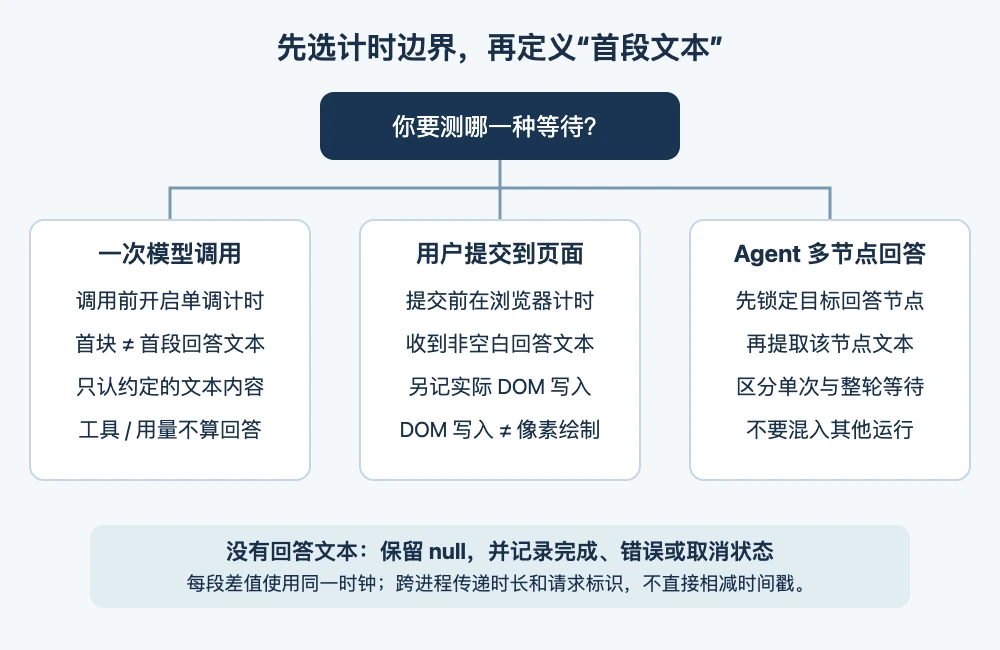
7. 按场景选埋点,不用一个“首Token”覆盖所有问题
- 查SDK或接入层何时有动静:记录首块,明确它可能为空。
- 比较单次模型的回答文本等待:调用前起表,筛选目标文本并记录首段非空白到达。
- 衡量用户提交后的体验:前端独立计时,覆盖此前端到服务端链路,并另记真实DOM提交。
- 有工具、重试或多节点:请求级和调用级分别统计,按目标回答身份过滤。
- 没有回答文本:保留null与退出状态,分别统计无文本、错误及取消。
空块要完全丢弃吗?它可能仍有角色或流信息,只是不触发首文计时。首文为null时可拿totalMs补吗?不能,两项含义不同,应先确认结束、错误、取消或工具中间步骤,再按业务处理。
-
专题
三国战纪-风云再起 整合版
-
专题
三国战纪-乱世枭雄
-
-
下载
- |
-
-
下载
- 《行尸走肉第一章》免安装中文汉化硬盘版下载
- 单机|436 MB
- 一款以动作冒险为主题的游戏
-
-
下载
- 《街头霸王X铁拳》免安装中文汉化硬盘版下载
- 单机|111MB
- 一款非常好玩的格斗游戏
-
-
下载
- |
-
-
下载
- 《暗黑破坏神3》免安装繁体中文正式版下载
- 单机|7630 MB
- 一款以角色扮演为主题的游戏
-
-
下载
- 《马克思佩恩3》免安装硬盘版下载
- 单机|27033 MB
- 一款以第三人称射击为主题的游戏