平时做技术实践时,很多问题不是概念不会,而是细节没串起来。拿“采用 Codex 10 分钟读懂一个陌生代码库:read-only 模式……”来说,它看着像小点,放到项目里常会牵出环境、配置、兼容性和维护成本。下面按实际采用顺序,把思路、关键写法和容易踩坑的地方讲清楚,便于大家直接对照操作。
在这个场景下,每个开发者的职业生涯里都有无数个"入职第一天":clone 下来一个几十万行的项目,前任已经跑路,文档还停留在两年前,而你需尽快搞清楚它怎么跑起来的。
自己啃,流程无非是:看 README → 猜目录结构 → 全局搜关键词 → 沿调用链跳文件。一个中型项目摸下来,两三天就进去了。
落到代码里,这篇讲用 Codex 做"入职第一天"的代码阅读——read-only 模式全程护航,10 分钟建立对一个陌生代码库的立体认知。
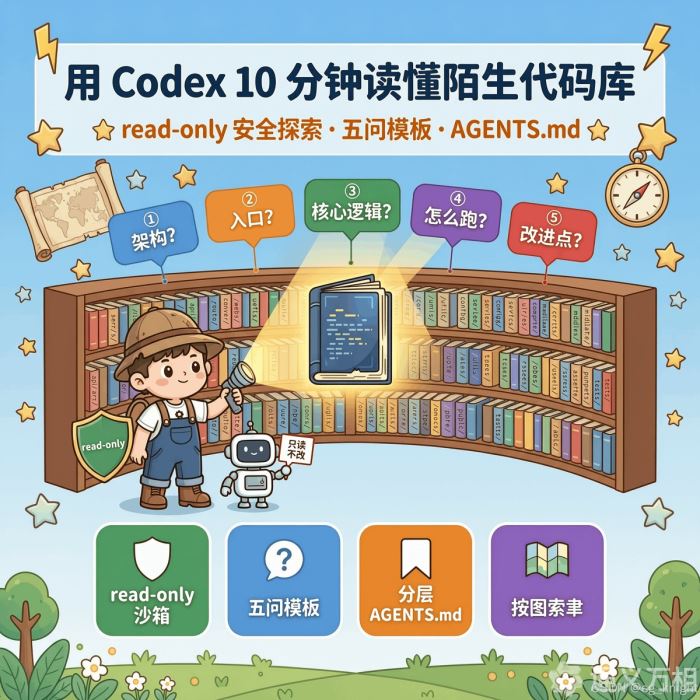
为什么是 read-only:探索陌生代码的安全前提
上一篇讲审批模式时说过:理解陌生代码,read-only 是最安全的模式。这里展开讲它在"探索"场景的独特价值。
从实现思路看,read-only 沙箱下,Codex 只能读、只能分析——不能改文件、不能跑命令。这意味着:
- 你怎么折腾都不会出事:陌生仓库里可能有敏感设置、奇怪的脚本、甚至恶意代码(供应链攻击场景),read-only 保证 Codex 不会执行其中任何东西
- 心理零负担:不需盯着它会不会误删什么,能够把注意力 100% 放在"理解代码"上
- 探索自由度拉满:想让它读哪个目录就读哪个目录,想问多深问多深,没有审批弹窗打断节奏
操作:进入项目目录,启动 Codex 后切到 read-only 模式(TUI 里用斜杠命令切换,或启动时指定)。确认右下角模式标识是 read-only,开始探索。
10 分钟实操流程
以一个中型全栈项目(前后端各半,约 10 万行)为例:
第 1 分钟:进场 + 模式确认
cd ~/projects/legacy-app
codex
实际处理时,TUI 启动后确认 read-only 模式生效。这一步不能省——模式错了,后面全错。
第 2 分钟:第一问——架构总览
这个项目的整体架构是什么?前后端怎么划分?各自的技术栈和目录职责是什么?
从实现思路看,Codex 会扫描目录结构、读 package.json / 依赖清单,给你一份架构摘要。这一问建立"地图感"——项目分几块、块在哪、用什么写的。
第 3-4 分钟:第二问——入口与启动链路
程序的入口文件是哪些?从启动到能对外服务,经历了哪些关键步骤?
理解这一步时,后端问 main/启动脚本,前端问路由入口。这一问搞清楚"代码从哪开始跑"——后续一切追踪都从入口延伸。
第 5-7 分钟:第三问——核心业务逻辑
理解这一步时,XX 功能(最核心的那个)的实现链路是什么?从 API 定义到数据落库,经过哪些文件?
带着你最关心的业务去问。Codex 会给出文件路径 + 调用链。拿到后自己打开一两个文件对一眼——验证它说的链路真实存在,同时你也在建立自己的理解。
第 8-9 分钟:第四问——构建与运行
这个项目怎么构建、怎么本地跑起来?有哪些常用命令(dev/test/lint)?
在这个场景下,从读代码转向动手准备。CI 设置、脚本清单扫一遍,等你真正要跑项目时直接照做。
第 10 分钟:第五问——改进点侦察
实际处理时,若要给这个项目做改进,你会优先关注哪些地方?有没有明显的技术债或风险点?
这一问的价值:Codex 的"新人视角"往往能挑出老团队习以为常的问题——过时的依赖、缺失的测试、可疑的硬编码。为后续你提优化建议攒素材。
提问的三个技巧
技巧一:由粗到细,别跳着问。先架构再入口再业务逻辑——顺序错了,你缺上下文,它答得也散。
技巧二:一次问一个维度落到代码里,。"架构是什么 + 入口在哪 + 怎么部署"塞一问里,答案会每个都浅。拆开问,每问都有深度。
技巧三:答案里出现陌生词,立刻追问落到代码里,。它提到"状态管理用的 Zustand"而你没听过——马上问"Zustand 在这个项目里怎么组织的?哪些文件相关?"乘热打铁,上下文还在。
分层 AGENTS.md:让下一次探索更快
结合项目来看,Codex 启动时会读取项目根目录的 AGENTS.md 作为基础上下文。如果你的团队维护了这份文件,Codex 对项目的理解会又快又准——不用每次从零扫描。
分层结构是加分项:
项目根/AGENTS.md          # 全局:技术栈、目录职责、通用规范
项目根/server/AGENTS.md   # 后端:API 约定、数据库结构、启动方式
项目根/web/AGENTS.md      # 前端:组件规范、状态管理、路由组织
从实现思路看,Codex 在哪个目录工作,就优先读哪一层的 AGENTS.md——子目录的规则覆盖全局的规则。接手的项目没有这份文件?花十分钟让 Codex(auto-edit 模式下)基于它的分析生成一份初稿,人工校对后提交——这是给下一个"入职新人"(包括未来的自己)留的路标。
和直接 grep 的效率对比
有人问:这些我自己 grep + 读文件也能做,为什么用 Codex?
| 维度 | 手动 grep | Codex read-only |
|---|---|---|
| 前置条件 | 你得先猜到关键词 | 直接问,不用猜 |
| 产出 | 一堆匹配行,自己拼逻辑 | 结构化总结,直接可读 |
| 全局感 | 逐点突破,容易迷失 | 先地图后细节 |
| 深度追问 | 每次重新组织搜索 | 上下文连续,越问越深 |
| 理解陌生项目 | 关键词都猜不准 | 从架构层切入 |
在这个场景下,核心差距在**“你得知道搜什么”**。陌生代码库里你最大的困境恰恰是不知道关键词——不知道入口叫什么、不知道核心模块在哪。Codex 从架构层切入,先给你地图,你的每个问题都变成"按图索骥"。
避坑提醒
坑一:忘了切模式就用 full-auto 探索理解这一步时,。探索陌生仓库务必 read-only——里面可能有恶意脚本或敏感数据,任何执行都有风险。
坑二:全信不验证结合项目来看,。Codex 的链路分析准确率很高,但关键结论(入口文件、核心调用链)动手前自己抽查确认——你要在它的结论上写代码,验证是给自己的保鲜。
坑三:只问不读结合项目来看,。Codex 的总结是"二手理解",自己打开文件看是"一手理解"。抽查环节既是验证,也是你建立项目肌肉记忆的过程。
坑四:忽略 monorepo 的目录层级实际处理时,。大型 monorepo 里先问"这个仓库包含哪些子项目",确定你关心的子目录再深入——一上来就问全仓库架构,答案会稀释。
总结
- 实际处理时,探索陌生代码库,read-only 是唯一建议模式:只读不写零风险,探索自由度拉满
- 五问模板按序走:架构 → 入口 → 核心逻辑 → 构建命令 → 改进点
- 提问由粗到细、一次一个维度、陌生词立刻追问
- 实际处理时,分层 AGENTS.md 让探索效率再提一档——没有就生成一份,给后来者留路标
- Codex 的价值是解决"不知道搜什么":先给你地图,再按图索骥
下一篇讲另一个高频刚需:把报错丢给 Codex,看它怎么从定位到修复走完全链路。
从实现思路看,总的来说,Codex适合结合实际项目边做边理解。先抓住核心思路,再逐步补上细节和边界处理,最后效果会更稳定,也更容易复用。